Sur cette page
- Une réponse ne peut pas être meilleure que les passages que la recherche rapporte : quand l'assistant se trompe, regardez d'abord ce qu'elle lui a donné.
- La recherche mixte lance deux recherches, par les mots et par le sens, et fusionne leurs classements : les numéros et les noms exacts ne se perdent plus.
- Le reclassement fait relire les meilleurs candidats par un second modèle, qui garde les plus pertinents ; il ajoute un délai et un coût à chaque question.
- Dans les tests publiés par Anthropic en 2024, ces réglages ensemble font passer les recherches qui échouent de 5,7 % à 1,9 %.
- On mesure la recherche à part de la réponse : sinon, on ne sait pas ce qu'il faut corriger.
Problème
Un salarié demande le préavis du contrat MX-200. La réponse dit trois mois ; c'est deux depuis l'avenant de l'an dernier. Le modèle de langage n'a rien inventé : il a résumé fidèlement les passages qu'on lui a donnés, et l'avenant n'en faisait pas partie. Dans un RAG, une réponse ne peut pas être meilleure que les passages que la recherche lui rapporte.
Les deux recherches de base ont chacune leur angle mort. Par le sens, l'outil rate un terme exact, un numéro de contrat ou un code d'erreur ; par les mots, il rate une même idée dite autrement. Un passage coupé de son document perd aussi ce qui le situait : « le préavis passe à deux mois » ne dit plus de quel contrat il s'agit.
La part des recherches qui échouent, étape par étape
Voir en tableau
| Étape | Recherches qui échouent | Échecs en moins |
|---|---|---|
| Recherche par le sens seule | 5,7 % | départ |
| Avec le contexte ajouté aux passages | 3,7 % | 35 % |
| Avec, en plus, la recherche par mots | 2,9 % | 49 % |
| Avec, en plus, le reclassement | 1,9 % | 67 % |
Source : Anthropic, « Introducing Contextual Retrieval », 19 septembre 2024, relu le 9 octobre 2026.
Principe
La recherche mixte. On lance les deux recherches sur la même question et on fusionne les deux classements en un seul. La fusion la plus répandue, la Reciprocal Rank Fusion, ne regarde que les rangs : un passage bien placé dans les deux listes passe devant un passage premier dans une seule. C'est ce que fait la recherche dans les fichiers d'OpenAI, et ce que documente pgvector avec la recherche plein texte de PostgreSQL.
Le contexte des passages. Avant de ranger un passage, on lui ajoute quelques lignes qui disent d'où il vient : le document, la partie, l'objet. Anthropic fait écrire ces lignes par un modèle, 50 à 100 tokens par passage, et les ajoute avant les deux recherches.
Le reclassement. Les deux recherches sont rapides parce qu'elles comparent des index. Un modèle de reclassement est plus lent mais plus fin : il lit la question et chaque candidat ensemble, et note leur pertinence. On le réserve donc aux meilleurs candidats ; Anthropic en reclasse 150 pour en garder 20.
Fonctionnement
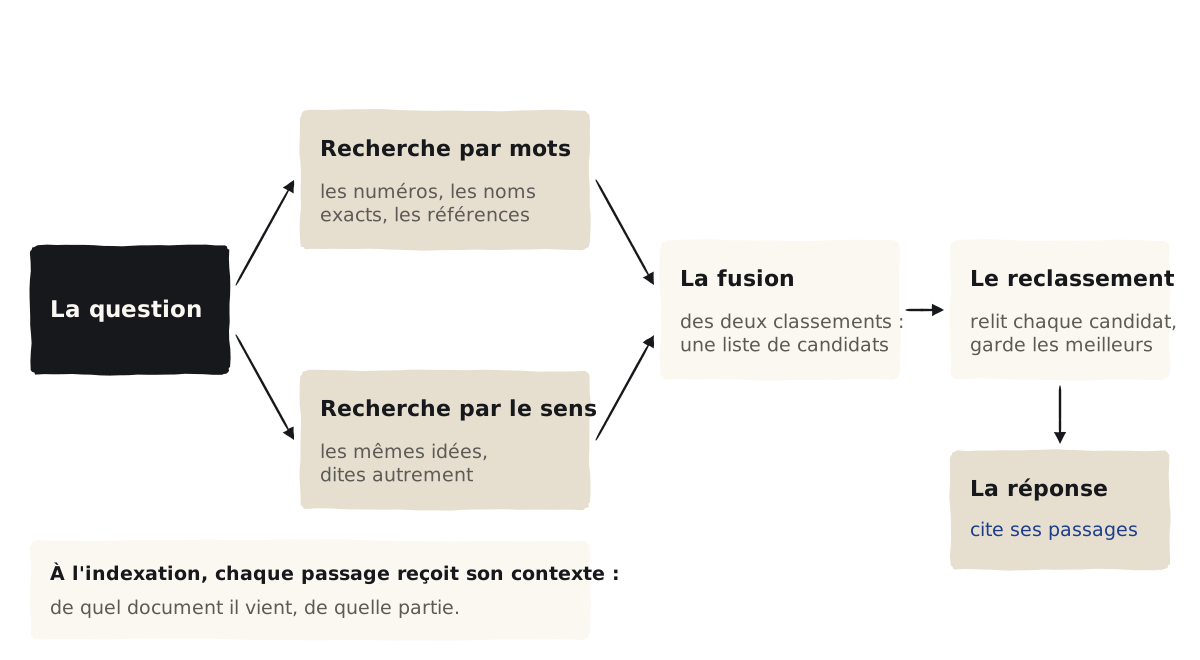
- À l'indexation, une fois par document : découper en passages courts, de quelques centaines de tokens, qui gardent leur titre ; leur ajouter leur contexte ; les ranger dans deux index, l'un par le sens, l'autre par les mots.
- Le filtre, à chaque question : écarter d'abord ce que la personne n'a pas le droit de lire, ou ce qui n'est pas du bon type, par les métadonnées des documents.
- Les deux recherches rapportent chacune leurs meilleurs passages, quelques dizaines à 150.
- La fusion en fait une seule liste de candidats, sans doublons.
- Le reclassement note chaque candidat avec la question et garde les meilleurs. Anthropic obtient de meilleurs résultats en donnant 20 passages au modèle plutôt que 10 ou 5.
- La réponse s'écrit sur ces passages, et les cite.
Exemple détaillé
La question : « Quel est le préavis pour résilier le contrat de maintenance MX-200 ? ». Six passages de la base, fabriqués pour l'exemple, avec leur rang dans chaque recherche. La fusion donne à chaque passage la somme de 1 / (60 + rang) sur les deux classements ; 60 est la valeur de l'article qui a proposé la méthode en 2009, qui la dit peu critique. Les scores sont multipliés par 1 000 pour se lire.
| Passage | Par mots | Par le sens | Fusion | Rang fusionné | Reclassement |
|---|---|---|---|---|---|
| A Contrat de maintenance MX-200, article 9 : la résiliation se fait avec un préavis de trois mois. | 2 | 3 | 32,001/(60 + 2) + 1/(60 + 3) | 1 | 0,94 · gardé |
| B Conditions générales d'achat : un contrat de maintenance se résilie par lettre recommandée, trois mois avant l'échéance. | 6 | 2 | 31,281/(60 + 6) + 1/(60 + 2) | 2 | 0,78 · gardé |
| C Fiche produit MX-200 : dimensions, consommation, garantie. | 1 | 8 | 31,101/(60 + 1) + 1/(60 + 8) | 3 | 0,12 |
| E Avenant de 2025 au contrat MX-200 : le préavis de résiliation passe à deux mois. | 4 | 5 | 31,011/(60 + 4) + 1/(60 + 5) | 4 | 0,91 · gardé |
| D Procédure interne : mettre fin à un engagement avec un prestataire. | 9 | 1 | 30,891/(60 + 9) + 1/(60 + 1) | 5 | 0,41 |
| F Liste des contrats de maintenance en cours, par fournisseur. | 3 | 7 | 30,801/(60 + 3) + 1/(60 + 7) | 6 | 0,08 |
Exemple fabriqué : les passages, les rangs et les notes du reclassement sont inventés pour montrer le calcul ; le calcul de la fusion, lui, est exact. Les rangs manquants (7, 8 par mots ; 4, 6 par le sens) sont d'autres passages de la base.
Ce que fait la fusion. La fiche produit C arrive première par mots, parce qu'elle répète « MX-200 », et huitième par le sens. La procédure D arrive première par le sens et neuvième par mots. Aucune des deux ne répond. La fusion remonte A, présente en bonne place dans les deux listes, et elle garde B ; mais C reste troisième et l'avenant E, qui change la réponse, n'est que quatrième.
Ce que fait le reclassement. Le modèle de reclassement relit la question avec chaque candidat et lui donne une note de pertinence. Il garde A, E et B, et écarte la fiche produit. La réponse peut alors dire : trois mois selon le contrat, ramenés à deux par l'avenant de 2025, en citant les deux passages. Avec les trois premiers de la fusion seule, l'avenant manquait, et la réponse aurait été fausse.
Risques
| Risque | Ce qui se passe | La parade |
|---|---|---|
| Régler sans mesurer | Un réglage qui aide sur un document en dégrade un autre, et personne ne le voit | Un jeu de questions fixe, mesuré avant et après chaque changement |
| Juger la recherche sur la réponse | Une réponse fausse peut venir d'un passage manquant ou d'un modèle qui a mal lu ; on corrige le mauvais étage | Deux mesures séparées : le rappel pour la recherche, la fidélité pour la réponse |
| Le délai du reclassement | Une étape de plus à chaque question ; plus on reclasse de candidats, plus elle coûte et plus elle tarde | Essayer plusieurs nombres de candidats sur vos questions, et garder le plus petit qui tient le rappel |
| Le coût du contexte | Un appel de modèle par passage à l'indexation, à refaire quand le document change ; 1,02 $ par million de tokens de documents dans le calcul d'Anthropic de 2024, avec Claude 3 Haiku et la mise en cache | Le faire sur les documents stables ; refaire le contexte d'un document seulement quand il change |
| Le document périmé bien classé | Le reclassement juge la pertinence, pas la date : un ancien contrat pertinent reste en tête | Retirer les versions remplacées de l'index : une base de fiches |
| Une limite cachée du reclassement | Cohere compte une recherche par question et par tranche de 100 documents, et découpe tout document de plus de 500 tokens, question comprise, en plusieurs documents | Lire les limites et l'unité de facturation de l'éditeur avant de fixer la taille des passages |
Mise en place
- Écrire le jeu de questions avant de toucher à quoi que ce soit : des questions réelles, chacune avec le passage où se trouve la réponse, et la réponse attendue. Anthropic conseille beaucoup de questions notées par un programme plutôt que quelques-unes notées à la main. La méthode : les jeux de tests.
- Mesurer la recherche seule : le rappel à k, la part des questions dont le passage attendu figure parmi les k premiers résultats. Anthropic mesure à 20 ; prenez le nombre de passages que vous donnez vraiment au modèle.
- Ajouter la recherche par mots, puis mesurer. Ce réglage n'ajoute aucun appel de modèle, quand l'outil ne le fait pas déjà.
- Ajouter le reclassement, puis mesurer le rappel et le délai d'une question.
- Ajouter le contexte des passages si le rappel reste insuffisant, en sachant qu'il faut réindexer.
- Mesurer la réponse à part : la fidélité, part des affirmations de la réponse que les passages appuient, de 0 à 1 ; le rappel du contexte demande la réponse de référence du jeu de questions.
La fusion et le rappel à k tiennent en quelques lignes, sans bibliothèque. Le programme ci-dessous reprend l'exemple de la page ; il n'appelle aucun modèle.
rag_avance_fusion.py# Fusion de deux classements (Reciprocal Rank Fusion) et rappel à k.
# Données fabriquées pour l'exemple de la page : les passages A à F, et d'autres passages de la base.
def fusionner(*classements, k=60):
"""Chaque classement est une liste d'identifiants, le meilleur d'abord.
Score d'un passage : somme de 1 / (k + rang) sur les classements où il figure."""
scores = {}
for classement in classements:
for rang, pid in enumerate(classement, start=1):
scores[pid] = scores.get(pid, 0.0) + 1.0 / (k + rang)
return sorted(scores.items(), key=lambda x: x[1], reverse=True)
def rappel_a_k(resultats, attendus, k):
"""Part des questions dont le passage attendu figure parmi les k premiers résultats."""
trouves = sum(1 for q, attendu in attendus.items() if attendu in resultats[q][:k])
return trouves / len(attendus)
par_mots = ["C", "A", "F", "E", "G", "B", "H", "I", "D"]
par_sens = ["D", "B", "A", "J", "E", "K", "F", "C"]
for pid, score in fusionner(par_mots, par_sens)[:6]:
print(f"{pid} {score:.5f}")
# Trois questions de test, chacune avec le passage qui contient la réponse.
resultats = {"q1": ["C", "A", "F"], "q2": ["B", "D", "E"], "q3": ["F", "C", "B"]}
attendus = {"q1": "A", "q2": "E", "q3": "D"}
print("rappel à 1 :", round(rappel_a_k(resultats, attendus, 1), 2))
print("rappel à 3 :", round(rappel_a_k(resultats, attendus, 3), 2))
python3 rag_avance_fusion.pyA 0.03200B 0.03128C 0.03110E 0.03101D 0.03089F 0.03080rappel à 1 : 0.0rappel à 3 : 0.67
Essayé le 9 octobre 2026 avec Python 3.12, sur les données fabriquées de l'exemple.
Sur trois questions, le passage attendu n'arrive jamais premier, mais deux fois parmi les trois premiers : rappel à 1 de 0, rappel à 3 de 0,67. Si le modèle reçoit trois passages, c'est le second chiffre qui compte.
Exercice
Une autre question, d'autres passages fabriqués. Par mots, l'ordre est P, Q, R, S ; par le sens, R, S, T, P. Calculez la fusion avec k = 60 : quels sont les trois premiers ?
Ouvrir la correction
Les scoresR : 1/63 + 1/61, soit 32,27 pour mille. P : 1/61 + 1/64, soit 32,02 pour mille. S : 1/64 + 1/62, soit 31,75 pour mille. Q : 1/62, soit 16,13 pour mille. T : 1/63, soit 15,87 pour mille.
Le classementR, P, S. Q et T, présents dans une seule liste, passent derrière, même Q qui était deuxième par mots.
Ce qu'il faut retenirLa fusion récompense l'accord entre les deux recherches ; un passage premier dans une seule liste ne gagne pas d'office.
Vérification
1ComprendrePourquoi combiner la recherche par mots et la recherche par le sens ?
Parce que chacune rate ce que l'autre trouve : les mots trouvent les termes exacts, un numéro ou un nom, et ratent les reformulations ; le sens trouve les reformulations et rate les termes exacts.
2AppliquerVotre assistant donne une réponse fausse. Quelle est la première chose à regarder ?
Si le passage qui contient la bonne réponse figurait parmi ceux donnés au modèle. S'il manquait, c'est la recherche qu'il faut corriger ; s'il y était, c'est la lecture du modèle, ou la demande.
3ComprendrePourquoi ne pas reclasser tous les passages de la base ?
Parce que le modèle de reclassement lit chaque passage avec la question : c'est fin, mais lent et payant. On le réserve aux meilleurs candidats des deux recherches rapides.
Lectures suivantes
Les pages qui renvoient ici
Limites et sources
Le graphique reprend une mesure d'Anthropic, de 2024, sur ses propres jeux de questions, avec des modèles de cette époque : il montre ce que chaque étape peut apporter, pas ce qu'elle apportera sur vos documents.
L'exemple détaillé et l'exercice portent sur des passages fabriqués ; les notes de reclassement de l'exemple sont inventées, le calcul de la fusion est exact. Les noms et prix des modèles de reclassement sont ceux relevés le 7 octobre 2026.
- Anthropic, Introducing Contextual Retrieval, 19 septembre 2024 ; Cormack, Clarke et Büttcher, Reciprocal Rank Fusion, SIGIR 2009.
- OpenAI, Retrieval ; pgvector ; Cohere, Rerank ; Cohere, Pricing ; Voyage AI, Rerankers.
- ragas, les mesures ; Faithfulness ; Context Recall ; Anthropic, Define success criteria and build evaluations.
- Le relevé :
apprendre/recherches/2026-10-07-rag-technique.json.
Écrit par Meridal, avec l'aide de l'IA ; chaque fait vérifié à sa source et relu avant publication. Texte et schémas sous licence CC BY 4.0 : reprenez-les en citant Meridal. Le code sous licence MIT.
Un assistant qui connaît votre entreprise
3 300 € à 10 200 €, puis sur devis