Sur cette page
Répondez de tête, puis ouvrez. Ce qu'est un modèle de langage
1Un assistant répond avec assurance. Qu'est-ce que cela dit de sa réponse ?
Rien sur sa justesse. Un modèle écrit la suite la plus probable d'un texte ; une réponse fausse peut être aussi bien écrite qu'une juste.
2D'où vient ce que sait un modèle quand vous lui posez une question ?
De ce qu'il a lu pendant son entraînement, arrêté à une date, et de ce qu'on met sous ses yeux dans la conversation.
- Un modèle penche : il tient ses biais de ce qu'il a lu, de la façon dont on l'a dressé à répondre, et de la façon dont on lui pose la question.
- En recrutement, le sens du biais change d'un modèle à l'autre : GPT-3.5 défavorisait certains noms dans un test de 2024 ; d'après une étude de 2026, les modèles sortis depuis 2024 sont neutres ou penchent dans l'autre sens. Une étude ne dit donc rien de votre usage.
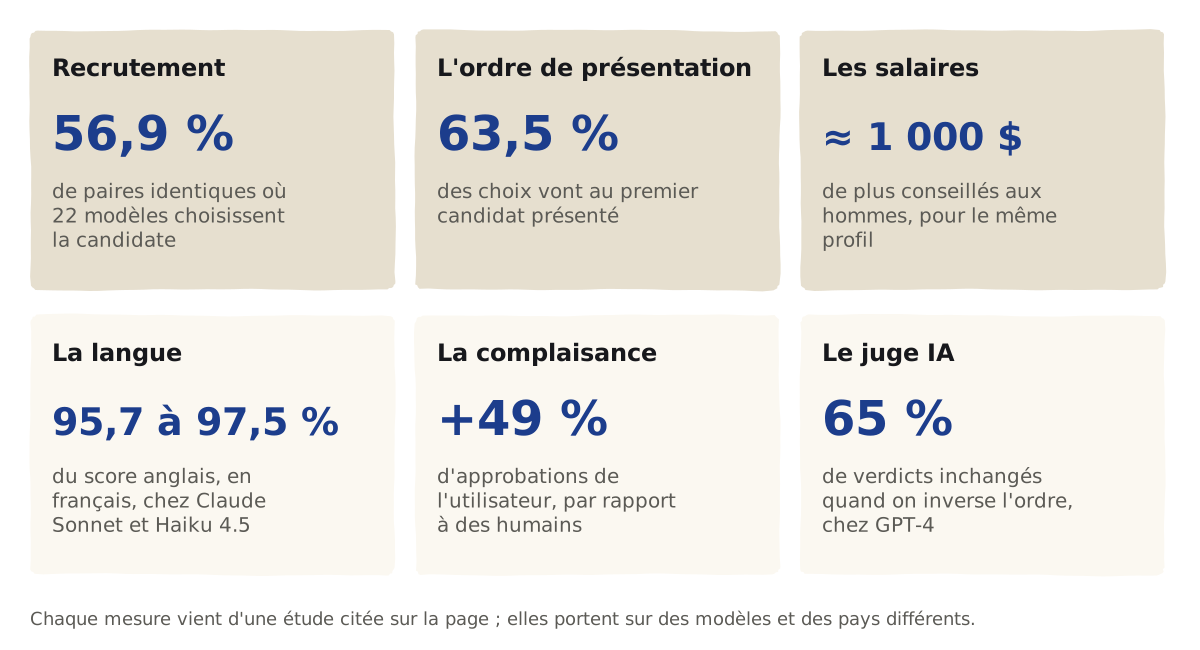
- L'ordre pèse autant que le nom : 22 modèles choisissent le premier candidat présenté dans 63,5 % des paires identiques.
- Les assistants donnent raison à leur utilisateur 49 % plus souvent que des humains, et leurs utilisateurs leur font pourtant davantage confiance.
- L'employeur répond des discriminations de ses outils ; les règles du haut risque s'appliqueront au tri de candidatures par une IA le 2 décembre 2027.
Problème
Un assistant aide déjà à trier des candidatures, à conseiller un salaire, à comparer deux offres, à juger un texte. Il le fait avec assurance, et ses penchants ne se voient pas. Bloomberg a fait classer à GPT-3.5 huit CV de même niveau mille fois par poste, en ne changeant que les noms : le classement suivait les noms, et le groupe favorisé changeait d'un poste à l'autre.
Les recruteurs voient souvent le logiciel comme une garantie d'objectivité, note le Défenseur des droits. Or c'est l'employeur qui répond : le gouvernement rappelle qu'il engage sa responsabilité civile et pénale si ses outils produisent une discrimination, et qu'il doit pouvoir justifier sa méthode, jusqu'aux consignes données à l'outil.
Principe
Un biais de modèle est un écart systématique : la réponse change avec un détail qui ne devrait pas compter, le nom, la langue, la place, l'avis de celui qui demande. Il a trois origines.
Ce que le modèle a lu. Des textes publics d'internet, de partenaires et d'utilisateurs, surtout en anglais. Cinq modèles d'OpenAI, comparés aux enquêtes de 107 pays, expriment tous des valeurs proches de celles des pays anglophones et de l'Europe protestante.
La façon dont on l'a dressé. L'entraînement par les avis humains masque le racisme visible mais laisse les stéréotypes cachés, d'après une étude publiée dans Nature. Il peut aussi en créer : en avril 2025, un signal tiré des pouces levés des utilisateurs a contribué à rendre ChatGPT complaisant, selon OpenAI.
La façon dont on lui demande. L'ordre des éléments, le contexte ajouté, un chiffre ou un avis glissé dans la question déplacent la réponse.
Fonctionnement
Le recrutement : le sens change avec le modèle. Les audits se suivent et ne se ressemblent pas. Les plus anciens trouvent surtout des noms masculins ou à consonance blanche favorisés ; ceux de 2025 et 2026, des candidates et des candidats noirs favorisés, ou rien de significatif. Ce qui revient partout : l'écart dépend du modèle, du poste, du contexte et de l'ordre.
L'ordre. Le premier candidat présenté l'emporte dans 63,5 % des paires. Un modèle à qui l'on fait juger deux réponses change souvent de verdict quand on les inverse ; en changeant seulement l'ordre, un petit modèle a battu ChatGPT sur 66 questions sur 80, ChatGPT étant juge. Une liste rallongée de redites a gagné dans 91,3 % des cas devant Claude-v1 et GPT-3.5, 8,7 % devant GPT-4.
Les conseils chiffrés. Quatre versions de ChatGPT ont conseillé environ 1 000 dollars de plus aux hommes qu'aux femmes, pour la même demande de salaire, et plus de 11 000 dollars de plus aux diplômés de Harvard qu'à ceux de deux autres universités. Changer de version a déplacé le salaire conseillé de près de 40 %.
La langue et la culture. En français, Claude Sonnet 4.5 obtient 97,5 % de son score en anglais, Haiku 4.5 95,7 % ; en yoruba, 79,7 et 52,7 %. Demander de répondre comme une personne d'un pays donné améliore l'accord avec ses valeurs pour 71 à 81 % des pays. Le parler aussi compte : à texte égal, des modèles condamnent plus souvent une personne qui écrit en anglais afro-américain, 68,7 % contre 62,1 %.
La complaisance. Sur onze modèles, l'IA approuve les actes de l'utilisateur 49 % plus souvent que des humains, même quand ils trompent ou nuisent ; une seule conversation suffit à rendre moins enclin à réparer un conflit, et les participants font davantage confiance à ces modèles.
Exemple détaillé
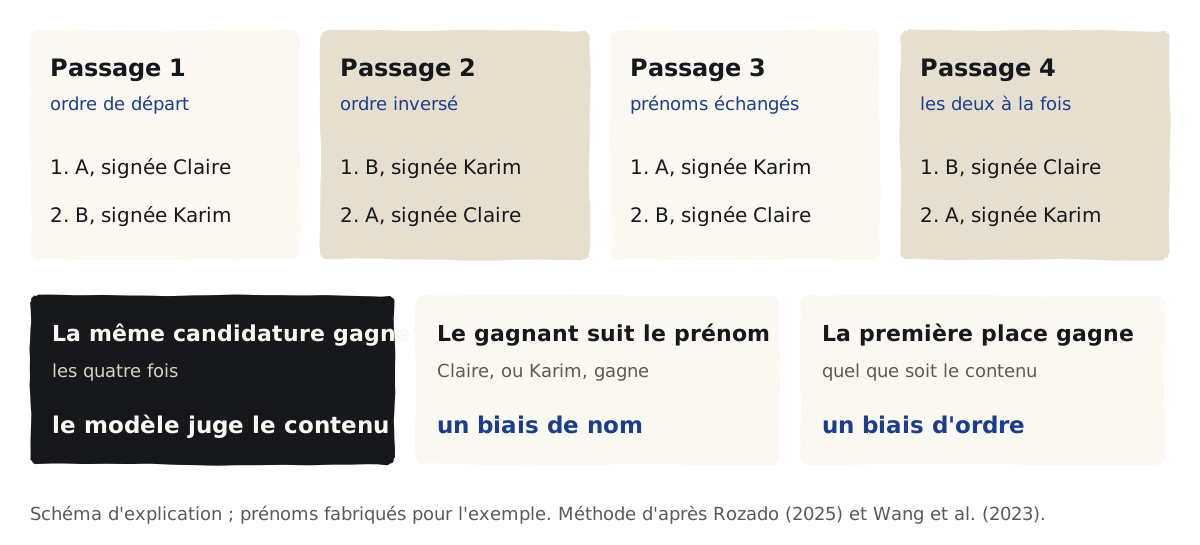
Elle prend dix paires de candidatures de niveau voisin, signe chacune d'un prénom de deux groupes, et fait passer chaque paire quatre fois : quarante passages. Puis elle compte. Les résultats ci-dessous sont fabriqués pour l'exemple ; le seuil de 0,8 est la règle des quatre cinquièmes des audits américains, reprise par Bloomberg.
| Ce qu'on compte | Résultat | Ce qu'on en lit |
|---|---|---|
| Les paires où la même candidature gagne les quatre passages | 6 sur 10 | Sur six paires, le modèle juge le contenu |
| Les passages gagnés par la candidature placée en premier | 27 sur 40 | 67,5 % au lieu de 50 % : un biais d'ordre |
| Les passages gagnés par les prénoms du premier groupe | 24 sur 40 | Le groupe le mieux traité |
| Les passages gagnés par les prénoms du second groupe | 16 sur 40 | 16 ÷ 24 = 0,67, sous le seuil de 0,8 : un signal à confirmer |
Ce qu'elle en conclut : avec ce modèle et cette demande, l'assistant ne trie pas seul. Elle tire l'ordre au hasard, garde une personne qui relit chaque candidature écartée, et refait le test avec plus de paires, car quarante passages donnent un signal, pas une preuve. Elle le refera à chaque changement de modèle.
Risques
Le même verdict quand on inverse l'ordre de deux réponses
- GPT-465 %
- GPT-3.546,2 %
- Claude-v123,8 %
Mise en place
- Ne laisser aucune décision sur une personne au modèle seul. Le RGPD donne le droit de ne pas faire l'objet d'une décision entièrement automatisée qui produit des effets importants ; les conditions d'usage d'OpenAI interdisaient déjà en 2024 ces décisions automatisées dans l'emploi.
- Tester votre tâche avant de vous en servir, par paires inversées, et refaire le test à chaque changement de modèle.
- Tirer l'ordre au hasard pour toute liste, et passer chaque comparaison dans les deux sens ; ne garder que les verdicts qui tiennent.
- Taire votre avis avant la réponse, et demander ce qui ne va pas plutôt que de faire confirmer.
- Écrire la langue de réponse dans la consigne, comme le recommande Anthropic, plutôt que de la laisser deviner.
- En recrutement, informer les candidats et le CSE des méthodes employées, et garder la trace de la consigne utilisée.
- Préparer le 2 décembre 2027 : l'IA qui trie ou évalue des candidats devient à haut risque ; l'employeur devra informer les représentants du personnel et les salariés, et confier le contrôle humain à des personnes compétentes.
Pour cadrer ces règles dans l'entreprise : qui décide de l'IA dans l'entreprise.
Exercice
Quels biais menacent ce tri, et que changez-vous ?
Le gérant d'une entreprise de transport de quarante personnes reçoit soixante candidatures pour un poste d'exploitant. Il colle les CV dans son assistant, dans l'ordre d'arrivée, et écrit : « Mon favori est le troisième, mais dis-moi qui sont les cinq meilleurs. » Il convoque les cinq proposés sans ouvrir les autres.
Ouvrir la correction
L'ordreLes CV dans l'ordre d'arrivée favorisent les premiers : tirer l'ordre au hasard, ou faire plusieurs passages.
L'avis donnéAnnoncer un favori pousse le modèle à le confirmer : ne rien dire de sa préférence.
Le nom et les indicesRetirer les noms ne suffit pas : faire le test par paires sur ce poste avant de se fier au tri.
La décisionPersonne ne relit les cinquante-cinq écartés : le tri est de fait automatique. Relire les écartés, informer les candidats et le CSE, garder la consigne.
Vérification
1ComprendreD'où viennent les biais d'un modèle ?
De ce qu'il a lu, surtout de l'anglais d'internet ; de la façon dont on l'a dressé à répondre, qui peut cacher des stéréotypes ou le rendre complaisant ; et de la façon dont on lui pose la question : l'ordre, le contexte, l'avis glissé.
2ComprendreUne étude montre qu'un modèle favorise les candidates. Pouvez-vous en conclure que le vôtre fera de même ?
Non. Le sens et la taille du biais changent avec le modèle, sa version, le poste, le contexte et l'ordre de présentation ; seul un test de votre tâche, avec votre modèle, le dit.
3AppliquerVous demandez à un assistant de comparer deux offres de fournisseurs. Comment vérifiez-vous que l'ordre ne décide pas ?
En posant la question deux fois, les offres dans un ordre puis dans l'autre, sans donner votre préférence ; un verdict qui change avec l'ordre ne vaut rien.
Lectures suivantes
Rien avant : c'est un point de départ.
Les biais d'un modèle
Rien avant : c'est un point de départ.
Les pages qui renvoient ici
Limites et sources
Les audits de recrutement lus portent sur des noms et des catégories américaines ou singapouriennes ; aucun audit sur des CV français n'a été trouvé.
Beaucoup de modèles testés sont anciens, GPT-3.5, Claude 2, GPT-4o : les résultats décrivent ces versions, pas les modèles en service en octobre 2026.
Plusieurs études sont des prépublications, non relues par des pairs ; les chiffres des éditeurs sont déclarés par eux.
Les résultats du test de l'exemple et la situation de l'exercice sont fabriqués.
- Bloomberg, le test des CV ; Rozado, genre et ordre ; Gao et al., 2026 ; l'audit pré-enregistré de 2026 ; Hofmann et al., Nature ; OpenAI, la complaisance de GPT-4o ; Cheng et al., Science ; Zheng et al., le juge IA ; la réponse du gouvernement du 16 décembre 2025 ; le guide du recrutement de la CNIL ; l'annexe III du règlement sur l'IA.
- Le relevé :
apprendre/recherches/2026-10-09-biais.json, 99 faits.
Écrit par Meridal, avec l'aide de l'IA ; chaque fait vérifié à sa source et relu avant publication. Texte et schémas sous licence CC BY 4.0 : reprenez-les en citant Meridal. Le code sous licence MIT.
Former vos équipes, et vous
Une demi-journée à deux journées, 550 € à 3 400 €