Sur cette page
- Un modèle de langage prédit la suite la plus probable d'un texte, un morceau après l'autre ; c'est ainsi qu'il écrit.
- Ce qu'il sait vient de ce qu'il a lu pendant son entraînement, arrêté à une date, et de ce qu'on met sous ses yeux dans la conversation.
- Il ne connaît pas vos documents, sauf si on les lui donne, et ne retient pas une conversation dans ses connaissances.
- Une réponse bien écrite n'est pas une réponse juste : le modèle a appris à écrire comme on écrit, pas à distinguer le vrai du faux.
- La même question peut recevoir deux réponses différentes : plusieurs suites sont plausibles, et le modèle en choisit une.
Problème
On parle à un assistant comme à un collègue : on lui pose une question, il répond avec aplomb, dans un français impeccable. On en déduit qu'il sait. Puis un jour, il cite une règle qui n'existe pas, ou ignore un fait de la semaine dernière, avec le même aplomb. Pour s'en servir sans s'y tromper, il faut savoir ce qu'il fait vraiment.
Principe
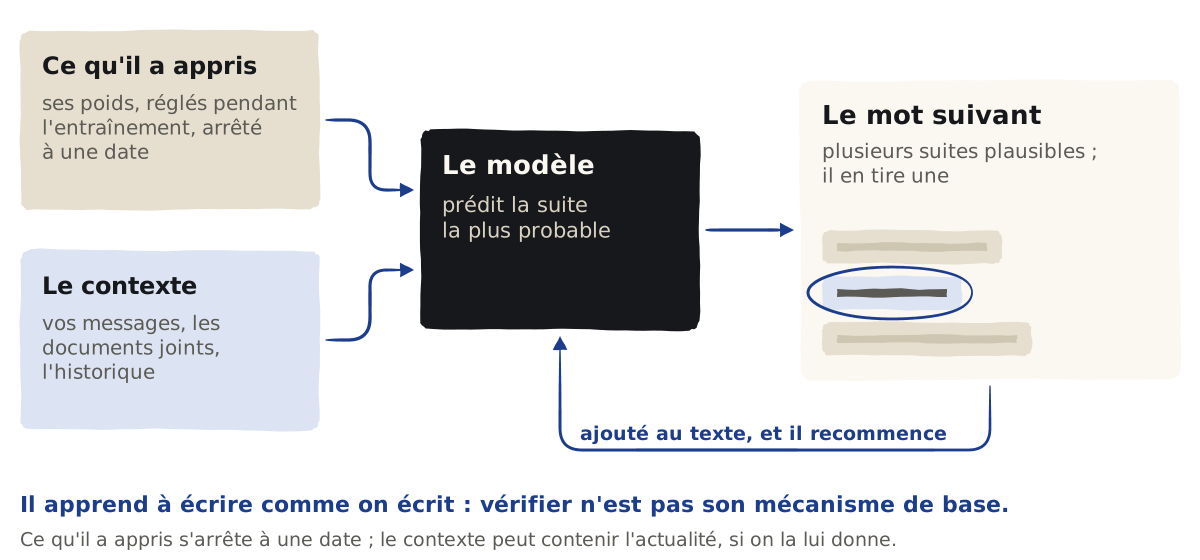
Un modèle de langage fait une seule chose : à partir d'un texte, il prédit la suite la plus probable, un mot ou un morceau de mot à la fois, puis recommence avec le texte allongé. OpenAI le décrit ainsi : le modèle prédit le mot suivant le plus probable, un mot à la fois.
Il a appris cette prédiction en lisant une très grande quantité de textes : contenus publics d'internet, données de partenaires, informations venues des utilisateurs et des personnes qui l'entraînent, chez OpenAI. Ce qu'il en garde n'est pas une copie des textes, mais des réglages, ses « poids », ajustés pendant l'entraînement.
Fonctionnement
Le pré-entraînement apprend à prédire le mot suivant sur un corpus immense, sans étiquette. Anthropic précise qu'un modèle ainsi entraîné n'est pas bon, de lui-même, pour répondre aux questions ou suivre des consignes.
Le post-entraînement lui apprend à répondre : des exemples de bonnes réponses, puis des personnes qui classent plusieurs réponses entre elles, et un apprentissage qui pousse le modèle vers les mieux classées.
La conversation : ce que vous écrivez, les documents joints et l'historique forment le contexte, la mémoire de travail du modèle, distincte de ce qu'il a appris. Ce qu'il a appris s'arrête à une date ; le contexte, lui, peut contenir l'actualité, si on la lui donne.
Le choix du mot suivant : plusieurs suites sont plausibles, et le modèle en tire une ; OpenAI y voit la raison pour laquelle la même question peut recevoir des réponses différentes. Même réglé au plus strict, il n'est pas entièrement prévisible, écrit Anthropic.
Pourquoi le faux peut être bien écrit : pendant son pré-entraînement, le modèle ne voit que des exemples de langue correcte, sans étiquette « vrai » ou « faux », écrit OpenAI. Il apprend à écrire comme on écrit ; vérifier n'est pas son mécanisme de base.
Exemple détaillé
Deux cas réels. D'abord, la date : un modèle ne sait rien de ce qui s'est passé après la fin de son entraînement. Relevé le 8 octobre 2026 :
Une question sur un changement de loi de septembre 2026 reçoit donc, sans recherche sur le web ni document joint, une réponse fondée sur l'état d'avant, souvent sans le dire.
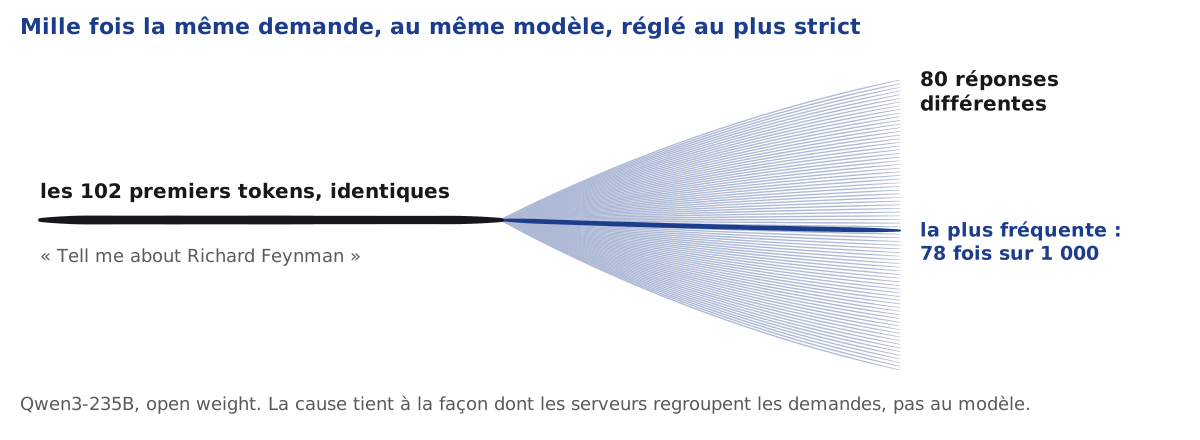
Ensuite, la variation : des chercheurs ont posé mille fois la même demande, « Tell me about Richard Feynman » (« Parle-moi de Richard Feynman »), au même modèle open weight, Qwen3-235B, réglé au plus strict. Ils ont obtenu 80 réponses différentes, identiques sur les 102 premiers tokens puis divergentes ; la plus fréquente revenait 78 fois. La cause tient à la façon dont les serveurs regroupent les demandes, pas au modèle.
Risques
| Ce qui trompe | Pourquoi | La parade |
|---|---|---|
| L'aplomb | Le modèle écrit aussi bien le faux que le vrai | Demander ses sources, et vérifier ce qui compte : vérifier une réponse d'IA |
| L'actualité | Ses connaissances s'arrêtent à une date, parfois plus tôt selon les domaines | La recherche sur le web de l'assistant, ou le document à jour joint à la demande |
| Vos documents | Il ne les a jamais lus | Les lui donner : le contexte d'une demande, le RAG |
| Un très long contexte | Anthropic écrit que la précision baisse quand le contexte s'allonge | Donner le nécessaire, pas tout |
| Une réponse unique | La même question peut recevoir une autre réponse | Reposer la question, ou demander deux versions, quand l'enjeu le justifie |
Mise en place
- Donner ce qu'il ne sait pas : le document, les chiffres, le contexte de l'entreprise.
- Demander d'où vient la réponse, et vérifier les chiffres, les noms et les dates.
- Pour l'actualité, activer la recherche sur le web, ou joindre la source.
- Pour l'essentiel, garder la décision : le modèle propose, la personne tranche.
- S'exercer : l'atelier pour réécrire cinq demandes.
Exercice
Vrai ou faux ?
- Un assistant a lu les documents de votre entreprise pendant son entraînement.
- Si on lui pose deux fois la même question, il donne forcément la même réponse.
- Une réponse bien rédigée et précise est le signe d'une réponse juste.
- Un document joint à la conversation est lu par le modèle pour cette réponse.
Ouvrir la correction
1. FauxIl a lu des textes publics et ceux de partenaires ; vos documents, seulement si on les lui donne dans la conversation.
2. FauxPlusieurs suites sont plausibles ; même réglé au plus strict, il peut varier.
3. FauxIl écrit aussi bien le faux que le vrai : la forme ne dit rien du fond.
4. VraiIl entre dans le contexte, la mémoire de travail de cette conversation ; il ne s'ajoute pas pour autant à ce que le modèle sait.
Vérification
1ComprendreUn assistant répond avec assurance. Qu'est-ce que cela dit de sa réponse ?
Rien sur sa justesse. Un modèle écrit la suite la plus probable d'un texte ; une réponse fausse peut être aussi bien écrite qu'une juste.
2ComprendreD'où vient ce que sait un modèle quand vous lui posez une question ?
De ce qu'il a lu pendant son entraînement, arrêté à une date, et de ce qu'on met sous ses yeux dans la conversation. Rien d'autre : il ne connaît pas vos documents, sauf si on les lui donne.
3AppliquerVous demandez à un assistant la règle en vigueur depuis le mois dernier. Que faire pour avoir une réponse fiable ?
Activer la recherche sur le web ou joindre le texte de la règle : ses connaissances s'arrêtent avant ; puis vérifier la source citée.
Lectures suivantes
Rien avant : c'est un point de départ.
Rien avant : c'est un point de départ.
Le modèle de langage expliqué simplement
L'IA en une heure pour le dirigeant · étape 3 sur 8
Limites et sources
Les dates de connaissance sont celles que publient les éditeurs, relevées le 8 octobre 2026.
Cette page décrit le mécanisme commun des modèles de langage ; chaque éditeur ajoute ses outils, comme la recherche sur le web.
- OpenAI, How ChatGPT and our foundation models are developed ; Anthropic, Glossary ; OpenAI, Why language models hallucinate ; Thinking Machines, Defeating Nondeterminism.
- Le relevé complet :
apprendre/recherches/2026-10-08-comprendre-modeles.json.
Écrit par Meridal, avec l'aide de l'IA ; chaque fait vérifié à sa source et relu avant publication. Texte et schémas sous licence CC BY 4.0 : reprenez-les en citant Meridal. Le code sous licence MIT.
Former vos équipes, et vous
Une demi-journée à deux journées, 550 € à 3 400 €