Sur cette page
Répondez de tête, puis ouvrez. Le modèle de langage
1D'où vient ce que sait un modèle quand vous lui posez une question ?
De ce qu'il a lu pendant son entraînement, arrêté à une date, et de ce qu'on met sous ses yeux dans la conversation. Rien d'autre : il ne connaît pas vos documents, sauf si on les lui donne.
2Vous demandez à un assistant la règle en vigueur depuis le mois dernier. Que faire pour avoir une réponse fiable ?
Activer la recherche sur le web ou joindre le texte de la règle : ses connaissances s'arrêtent avant ; puis vérifier la source citée.
- L'IA aide le plus sur l'écriture, la synthèse et l'explication, quand une personne sait vérifier le résultat : les études mesurent de 15 % à plus de 40 % de mieux selon la tâche.
- Sur une tâche hors de sa portée, elle répond aussi bien qu'ailleurs, et fait moins bien qu'une personne seule : la limite ne se voit pas.
- Les débutants gagnent le plus ; les plus expérimentés, peu, et parfois rien.
- Le gain ressenti n'est pas le gain mesuré : des développeurs se croyaient 20 % plus rapides avec l'IA, et l'étaient 19 % moins.
- Pour commencer, une tâche fréquente, vérifiable, aux conséquences limitées ; jamais une tâche rare et lourde de conséquences.
Problème
Un dirigeant entend tout et son contraire : l'IA ferait gagner des heures par jour, ou ne servirait à rien. En France, 18 % des entreprises d'au moins dix salariés s'en servaient en 2025, et 71 % de celles qui ne s'en servent pas disent n'en voir aucun usage. Les deux camps ont des exemples. La question utile n'est pas « l'IA marche-t-elle ? », mais « sur quelles tâches, et comment le savoir ? ».
Principe
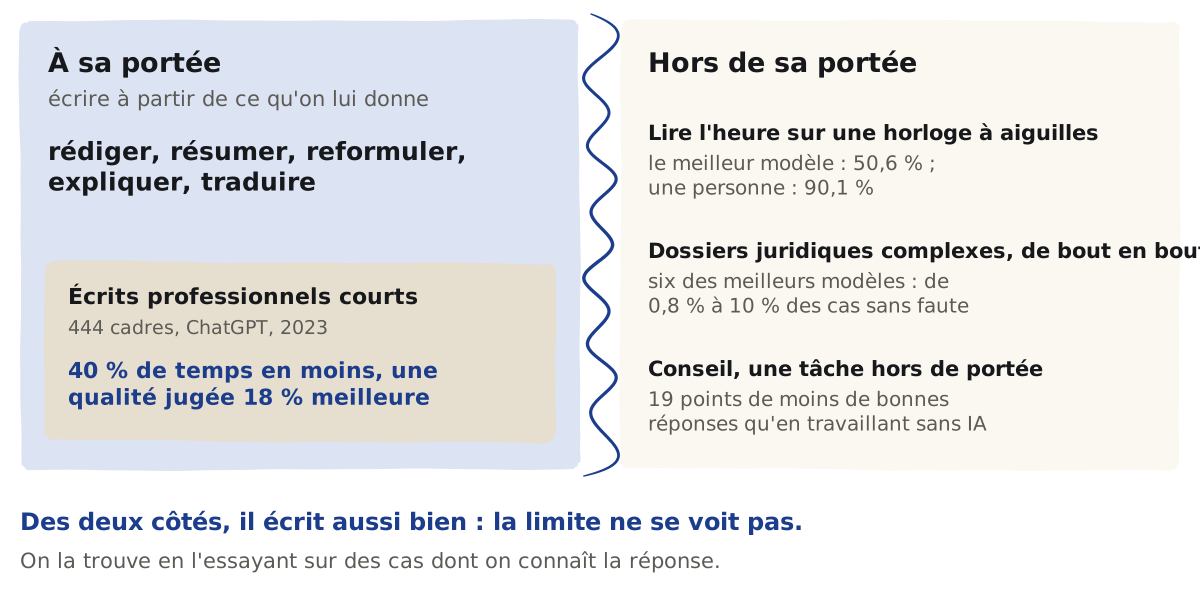
Un modèle de langage écrit la suite la plus probable d'un texte. Il excelle donc là où la tâche est d'écrire à partir de ce qu'on lui donne : rédiger, résumer, reformuler, expliquer, traduire. Au travail, les conversations avec Claude produisent d'abord des documents et des rapports (20 %), des explications (9 %) et des brouillons de courriel (7 %), d'après les données d'usage d'Anthropic.
Ailleurs, sa réussite ne suit pas la difficulté apparente. Des chercheurs de Harvard et du BCG parlent d'une frontière irrégulière : deux tâches qui semblent aussi difficiles l'une que l'autre peuvent être faciles pour l'IA, ou hors de sa portée. Le meilleur modèle mesuré par l'AI Index 2026 de Stanford lit l'heure sur une horloge à aiguilles une fois sur deux (50,6 %), contre 90,1 % pour une personne. Sur des dossiers juridiques complexes menés de bout en bout, six des meilleurs modèles réussissent sans faute entre 0,8 % et 10 % des cas, d'après la fiche de Gemini 3.8 Flash publiée par Google.
Et quand la tâche est hors de sa portée, le modèle ne prévient pas : il écrit aussi bien.
Fonctionnement
Huit études qui comparent un groupe avec IA à un groupe sans, sur de vraies tâches. Elles ne mesurent pas toutes la même chose, et elles datent : les modèles de 2023 font moins bien que ceux de 2026. Mais elles dessinent la même carte.
Ce qui revient d'une étude à l'autre. Le gain est net quand la tâche consiste à écrire ou à expliquer, et qu'une personne sait juger le résultat. Il va surtout aux moins expérimentés : l'IA leur apporte ce que les autres savent déjà. Il disparaît, ou s'inverse, quand la tâche demande une connaissance que le modèle n'a pas, sur un terrain que la personne connaît mieux que lui. Et on apprend moins en faisant faire qu'en faisant.
Exemple détaillé
Une semaine triée. Les tâches de l'assistante de direction d'une PME de quarante personnes, triées selon les mesures ci-dessus. L'entreprise et ses tâches sont fabriquées pour l'exemple.
| Tâche | Fréquence | Verdict | Pourquoi |
|---|---|---|---|
| Le compte rendu de la réunion d'équipe | Chaque semaine | À confier, relu | Un texte écrit à partir des notes qu'on lui donne ; une personne présente sait le vérifier |
| Les réponses aux demandes de devis simples | Plusieurs fois par jour | À confier, relu | Le modèle écrit le courriel ; les prix viennent du tarif, jamais de lui |
| La relance des factures impayées | Chaque semaine | En partie | La liste des impayés sort du logiciel comptable, par une règle ; le modèle rédige la relance |
| Le contrôle des notes de frais | Chaque mois | Aux règles, pas au modèle | Des montants et des plafonds : un tableur les vérifie sans se tromper |
| Le dossier de subvention annuel | Une fois par an | Pas pour commencer | Rare et lourd de conséquences : on ne mesure aucun gain, et une erreur coûte cher |
| L'entretien annuel d'un salarié | Une fois par an | À garder | Un jugement sur une personne, qui ne se délègue pas |
Dans des projets réels. Les trois réalisations ci-dessous viennent d'un même cabinet. Dans chacune, le modèle est placé là où il écrit ou choisit, et tenu à l'écart des montants.
Le modèle rédige, il ne calcule pas
Pour le document remis aux acquéreurs, une chaîne reprend les chiffres des fichiers du client, les range, les calcule et les contrôle par des règles. Le modèle de langage rédige le commentaire ; il ne calcule aucun montant, et un chiffre douteux est mis de côté, jamais comblé.
Le modèle choisit entre des options, jamais un chiffre
Un outil lit les liasses fiscales et remplit le modèle financier du cabinet : environ 80 % de la lecture par des règles, 20 % par le modèle, limité à des choix fermés. Un écart est signalé, jamais corrigé en douce.
L'IA réduit la pile, une personne la finit
Un contrôle des documents avant leur envoi, puis l'audit de toutes les images des documents archivés, pour retrouver ce qui laisserait reconnaître un vendeur anonyme. Une fuite a été retrouvée ; une partie des images reste à voir par une personne.
Risques
| Ce qui trompe | Pourquoi | La parade |
|---|---|---|
| La limite invisible | Hors de sa portée, le modèle répond aussi bien qu'ailleurs, et fait moins bien qu'une personne seule | L'essayer d'abord sur des cas dont vous connaissez la réponse |
| Le sentiment d'aller vite | Des développeurs se croyaient plus rapides et étaient plus lents | Mesurer le temps réel, avant et après, sur des tâches comparables |
| Le premier jet pris pour un texte fini | Un fait, un chiffre ou un nom peut être faux sans que rien ne le signale | Relire ce qui compte : vérifier une réponse d'IA |
| La compétence qui s'émousse | Faire faire n'apprend pas : les études le mesurent chez des ingénieurs et des lycéens | Pour apprendre, demander des explications plutôt que la réponse : ceux qui l'ont fait ont mieux retenu |
| La tâche rare et lourde | Pas assez de répétitions pour mesurer un gain ; une erreur qui coûte cher | La garder pour plus tard, une fois l'outil éprouvé ailleurs |
Mise en place
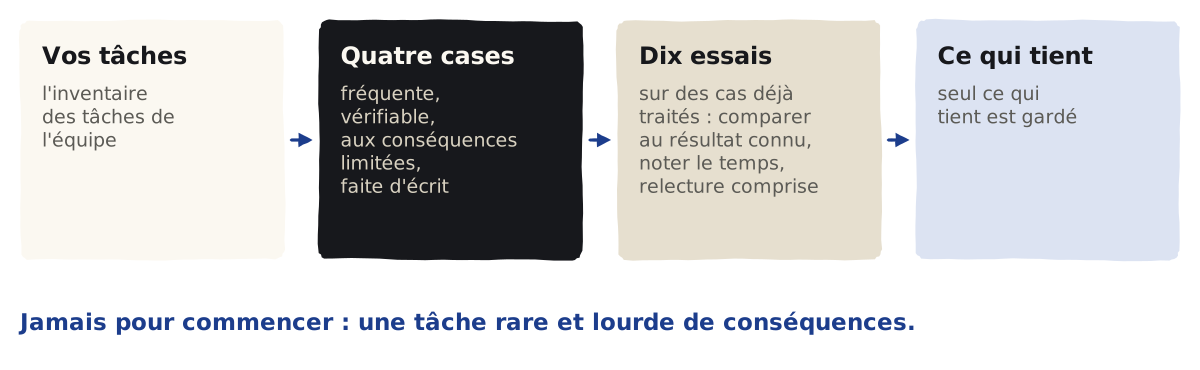
Une bonne première tâche coche quatre cases :
- Fréquente : au moins chaque semaine, pour que le gain compte et se mesure.
- Vérifiable : quelqu'un de l'équipe sait dire, en le lisant, si le résultat est juste.
- Aux conséquences limitées : une erreur se rattrape avant de coûter.
- Faite d'écrit : rédiger, résumer, reformuler, expliquer, à partir de ce qu'on donne au modèle.
Ensuite : la faire dix fois avec l'IA sur des cas déjà traités, comparer au résultat connu, noter le temps passé, relecture comprise ; ne garder que ce qui tient. Pour dresser la liste de départ : l'inventaire des tâches ; pour choisir : le choix d'un premier projet.
Exercice
Pour chaque tâche, choisissez : à confier avec relecture, à confier en partie, ou à garder. Les tâches sont fabriquées pour l'exercice.
- Résumer en thèmes les quarante avis clients reçus dans le mois.
- Calculer le montant des primes de fin d'année de chaque salarié.
- Traduire en anglais la fiche d'un produit du catalogue.
- Répondre, une fois par an, au grand appel d'offres d'un client public.
- Préparer l'ordre du jour du comité de direction, à partir des notes de chacun.
Ouvrir la correction
1. À confier, reluUne synthèse d'écrits donnés au modèle ; relire quelques avis pour vérifier que les thèmes tiennent.
2. À garderDes montants exacts sur des données personnelles : une formule de tableur, pas un modèle qui écrit.
3. À confier, reluPar quelqu'un qui lit l'anglais, surtout pour les termes techniques et les chiffres.
4. En partie, et pas pour commencerRare et lourd de conséquences ; l'IA peut aider à relire ou reformuler une fois l'outil éprouvé ailleurs.
5. À confier, reluÉcrire à partir de notes données : le cœur de ce qu'un modèle fait bien.
Vérification
1ComprendreUne IA rédige un premier jet de compte rendu. Qu'est-ce qui reste à faire ?
Le relire et le corriger : un modèle écrit vite et bien, mais peut se tromper sur un fait, un chiffre ou un nom, sans le signaler.
2ComprendrePourquoi une tâche rare et lourde de conséquences convient-elle mal à un premier essai ?
Parce qu'on ne peut ni mesurer le gain, faute de répétition, ni absorber une erreur ; une tâche fréquente et contrôlable s'y prête mieux.
3AppliquerVos équipes disent gagner beaucoup de temps avec l'IA. Comment le savoir ?
Mesurer le temps réel, relecture comprise, avant et après, sur des tâches comparables : dans une étude, des développeurs se croyaient 20 % plus rapides et étaient 19 % plus lents.
Lectures suivantes
Rien avant : c'est un point de départ.
Forces et limites de l'IA
L'IA en une heure pour le dirigeant · étape 4 sur 8
Limites et sources
Les études citées datent de 2023 à 2026, sur des modèles parfois dépassés ; elles mesurent des tâches précises, dans des entreprises précises, souvent américaines. Elles indiquent une direction, pas un gain garanti chez vous.
La suite de l'étude de METR, fin 2025, trouve plutôt un gain, mais METR la juge elle-même peu fiable, à cause de la façon dont les participants ont été choisis.
Les chiffres d'usage de Claude et l'étude sur l'apprentissage viennent d'Anthropic, l'éditeur ; les autres études sont indépendantes.
- Harvard Business School et BCG, Navigating the Jagged Technological Frontier ; Generative AI at Work, Quarterly Journal of Economics ; Noy et Zhang, Science ; METR, 2025 ; Anthropic, 2026 ; PNAS, 2025 ; NBER, étude danoise.
- Le relevé complet :
apprendre/recherches/2026-10-08-comprendre-modeles.json. Les réalisations :14-realisations-reelles.md.
Écrit par Meridal, avec l'aide de l'IA ; chaque fait vérifié à sa source et relu avant publication. Texte et schémas sous licence CC BY 4.0 : reprenez-les en citant Meridal. Le code sous licence MIT.
Le diagnostic
Deux à cinq jours, 1 100 € à 4 250 € selon le nombre de services