Sur cette page
Répondez de tête, puis ouvrez. La carte des acteurs de l'IA
1L'éditeur d'un assistant et le fabricant du modèle sont-ils toujours la même entreprise ?
Non : Microsoft Copilot s'appuie sur des modèles d'OpenAI et d'Anthropic, et un même assistant peut proposer les modèles de plusieurs fabricants.
2Que veut dire « open weight » ?
Que les poids du modèle sont publiés : on peut le faire tourner sur ses propres machines, dans les limites de sa licence.
- Une note ne veut rien dire sans quatre choses : qui l'a mesurée, sur quel test, avec quel réglage, dans quelle version du test.
- Une note publiée par l'éditeur se mesure avec ses propres réglages, souvent avec des outils et l'effort maximal : elle se compare mal à une mesure indépendante.
- Un test où tous les modèles dépassent 90 % ne les départage plus : un ou deux points d'écart sont du bruit.
- Le harnais, c'est-à-dire le programme qui fait travailler le modèle, peut faire varier une note de vingt points ou plus.
- Un classement dit un ordre sur ses tâches ; seule une mesure sur vos tâches dit lequel convient chez vous.
Problème
Chaque semaine, un éditeur annonce « le meilleur modèle du monde », chiffres à l'appui. Les classements publics donnent d'autres chiffres, et ne mettent pas tous les mêmes modèles en tête : au relevé du 6 octobre 2026, sur vingt-deux tests, neuf modèles différents arrivaient premiers (le marché des modèles). Pour choisir, il faut savoir lire ce que mesure un chiffre.
Principe
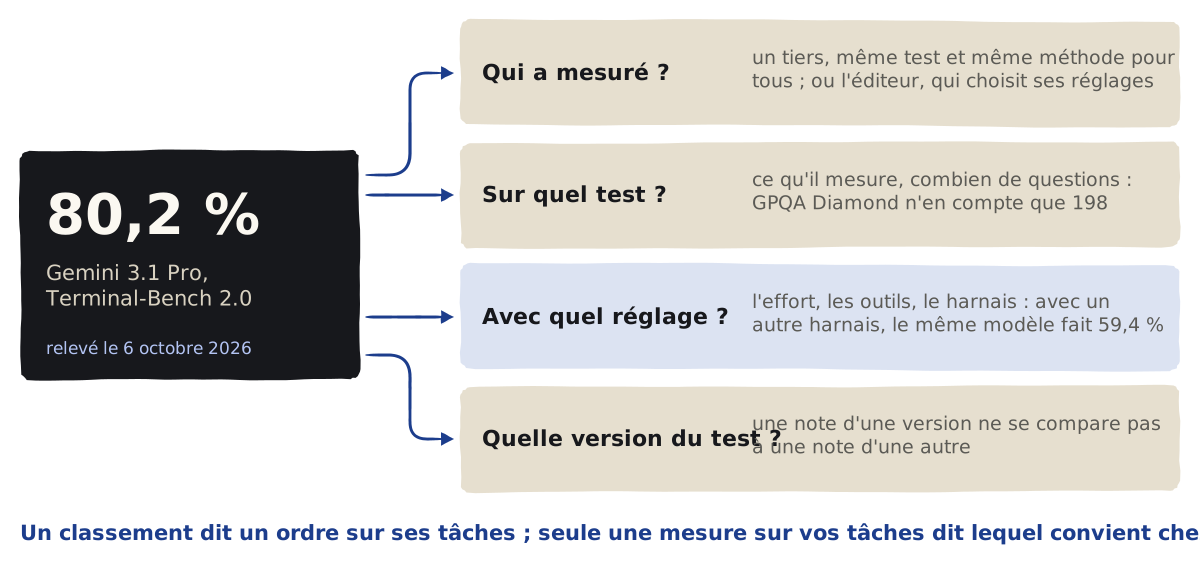
Quatre questions devant une note :
- Qui a mesuré : un tiers, qui fait passer le même test à tous les modèles avec la même méthode, ou l'éditeur du modèle, qui choisit ses réglages.
- Sur quel test : ce qu'il mesure, combien de questions il compte, et s'il départage encore les meilleurs.
- Avec quel réglage : l'effort de raisonnement, les outils permis, et le harnais, le programme qui fait travailler le modèle sur les tâches d'agent.
- Quelle version du test : les tests changent de version, et une note d'une version ne se compare pas à une note d'une autre.
Fonctionnement
Un test de questions donne une part de bonnes réponses. Plus il compte de questions, moins le hasard pèse : GPQA Diamond n'en a que 198, si bien qu'un ou deux points d'écart y sont du bruit.
Un test d'agent fait accomplir des tâches : corriger un vrai bug de logiciel, mener une suite de commandes dans un terminal. La note dépend alors autant du harnais que du modèle.
Une arène de préférence, comme LMArena, fait comparer deux réponses à l'aveugle par des internautes : elle mesure ce que les gens préfèrent, le ton, la forme, pas la justesse.
Un indice, comme celui d'Artificial Analysis, fait la moyenne de plusieurs tests ; il dépend des tests choisis et change de version.
Un test saturé ne départage plus : quand les meilleurs modèles dépassent tous 90 %, l'écart restant tient du bruit. Un test public peut aussi se retrouver dans les données d'entraînement : c'est la contamination, un risque fort pour les tests construits sur des dépôts de code publics.
Exemple détaillé
Risques
| Le piège | La parade |
|---|---|
| Prendre une préférence pour une justesse | Une arène dit ce qu'on aime lire ; un test à réponses dit ce qui est juste |
| Comparer deux versions d'un test | Ne comparer que des notes de la même version, chez la même source |
| Comparer deux réglages | Même effort, mêmes outils, même harnais ; sinon, le dire |
| Croire un écart d'un ou deux points | Regarder la taille du test et sa saturation ; préférer les tests qui départagent encore |
| Se fier à un seul indice | Deux indices classent autrement les mêmes modèles ; lire plusieurs tests |
Mise en place
- Devant une annonce : retrouver qui a mesuré, le test, le réglage et la version ; sans eux, la note ne dit rien.
- Pour un premier tri : les mesures indépendantes, sur les tests qui départagent encore ; le marché des modèles les rassemble, datées.
- Pour choisir : deux ou trois modèles essayés sur vos propres tâches, avec une grille notée : l'atelier pour comparer trois modèles.
Exercice
Un éditeur annonce : « Notre modèle atteint 96,4 % sur GPQA Diamond, deux points devant le meilleur concurrent ; mesuré avec outils et effort maximal. » Que retenir ?
Ouvrir la correction
Presque rienLa note est publiée par l'éditeur, avec ses réglages les plus favorables ; le test compte 198 questions et ne départage plus les meilleurs. Deux points d'écart y sont du bruit. Pour juger, il faut une mesure indépendante sur des tests qui départagent encore, puis un essai sur vos tâches.
Annonce fabriquée.
Vérification
1ComprendreUne note publiée par l'éditeur du modèle vaut-elle une note mesurée par un tiers ?
Pas sans le dire : l'éditeur mesure avec ses propres réglages, souvent avec des outils et l'effort de raisonnement maximal. La carte des notes marque chaque mesure d'éditeur d'un coin.
2AppliquerDeux modèles ont un point d'écart sur un test où tous dépassent 90 %. Lequel prendre ?
Le test ne les départage plus : l'écart est du bruit. Il faut regarder les tests qui départagent encore, et surtout essayer les deux sur vos tâches.
3ComprendreQue mesure une arène comme LMArena ?
La préférence de personnes qui comparent deux réponses à l'aveugle : le ton et la forme comptent, pas seulement la justesse.
Lectures suivantes
Rien avant : c'est un point de départ.
Lecture d'un classement de modèles
Les pages qui renvoient ici
Limites et sources
Les cas cités viennent des classements relevés le 6 octobre 2026 ; les notes changent à chaque version de modèle ou de test.
Cette page explique comment lire une note ; elle ne classe aucun modèle.
- Les classements, chaque note avec sa source et sa date :
apprendre/donnees/classements.json, et la page du marché des modèles.
Écrit par Meridal, avec l'aide de l'IA ; chaque fait vérifié à sa source et relu avant publication. Texte et schémas sous licence CC BY 4.0 : reprenez-les en citant Meridal. Le code sous licence MIT.
Choisir un outil ou un abonnement
275 € à 850 €