Sur cette page
Répondez de tête, puis ouvrez. Le modèle de langage
1Un assistant répond avec assurance. Qu'est-ce que cela dit de sa réponse ?
Rien sur sa justesse. Un modèle écrit la suite la plus probable d'un texte ; une réponse fausse peut être aussi bien écrite qu'une juste.
2D'où vient ce que sait un modèle quand vous lui posez une question ?
De ce qu'il a lu pendant son entraînement, arrêté à une date, et de ce qu'on met sous ses yeux dans la conversation. Rien d'autre : il ne connaît pas vos documents, sauf si on les lui donne.
- Un modèle qui raisonne écrit d'abord une réflexion invisible, où il planifie, essaie et se corrige ; puis il répond.
- Cette réflexion se paie au prix du texte écrit, même quand vous n'en voyez qu'un résumé, ou rien : de quelques centaines à des dizaines de milliers de tokens par réponse.
- Elle aide sur les mathématiques, le code et les plans en plusieurs étapes ; sur une recherche de fait ou un classement, elle n'apporte presque rien.
- Plus long n'est pas toujours mieux : au-delà d'une certaine difficulté, tous les modèles échouent, et sur certaines tâches, réfléchir plus longtemps fait moins bien.
- La plupart des modèles de 2026 ont des niveaux de réflexion : commencer bas, monter seulement si une mesure sur vos cas le justifie.
Problème
Deux assistants reçoivent la même question. L'un répond en deux secondes ; l'autre affiche « réflexion en cours » pendant une minute, puis répond en trois lignes. Le second est-il meilleur ? Il est en tout cas plus cher, et pas seulement en temps : ce qu'il a écrit pendant cette minute, vous le payez.
Principe
Un modèle de langage ordinaire écrit sa réponse d'un trait. Un modèle qui raisonne a été entraîné à écrire d'abord une longue réflexion pour lui-même : il découpe le problème, essaie une piste, la vérifie, en change s'il le faut, puis rédige la réponse. OpenAI décrit des modèles entraînés à affiner leur réflexion, à essayer plusieurs stratégies et à reconnaître leurs erreurs.
Cette habitude s'apprend par renforcement : on récompense les réponses justes, et le modèle découvre seul qu'une réflexion plus longue y mène plus souvent. DeepSeek l'a montré sans fournir un seul exemple de raisonnement écrit par une personne : pendant l'entraînement, son modèle s'est mis de lui-même à réfléchir plus longtemps, et sa réussite à un concours de mathématiques est passée de 15,6 % à 77,9 %.
La réussite monte aussi avec le temps de réflexion accordé au moment de répondre : c'est le réglage qu'on vous propose.
Fonctionnement
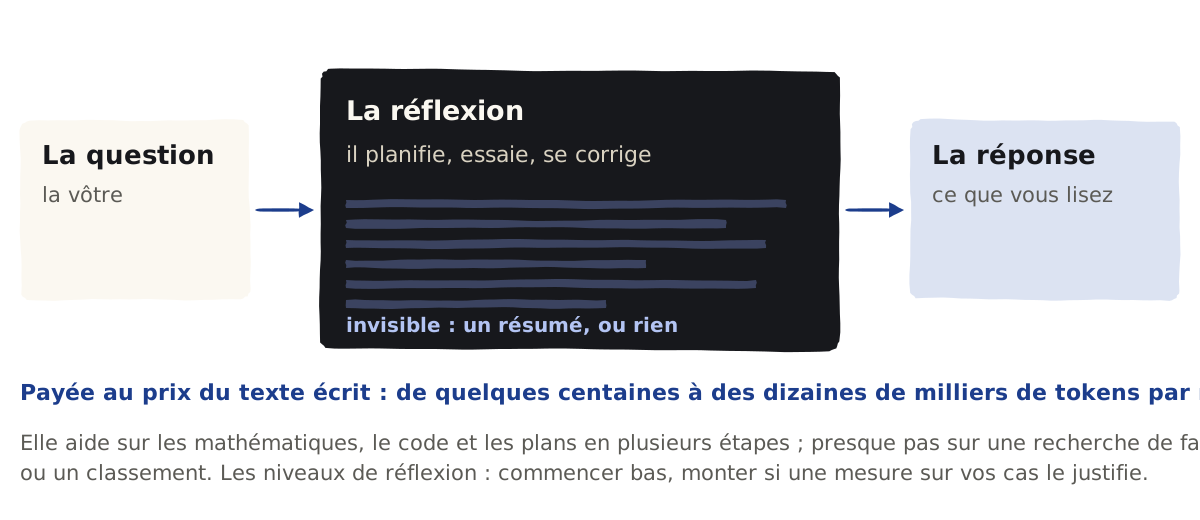
Les trois grands éditeurs fonctionnent de la même façon : un réglage de la profondeur de réflexion, une réflexion cachée, et une facture qui la compte en entier.
Exemple détaillé
Ce que coûte une réponse de trois lignes. Une réponse visible de 200 tokens, environ trois lignes, selon la longueur de la réflexion qui la précède. Les longueurs de réflexion sont des hypothèses, dans la fourchette que donne OpenAI ; le calcul, lui, est celui de la facture.
| Réflexion avant la réponse | Réponse visible | Tokens facturés en sortie | Par rapport à la réponse seule |
|---|---|---|---|
| Aucune | 200 tokens | 200 | 1 fois |
| 2 000 tokens | 200 tokens | 2 200 | 11 fois |
| 20 000 tokens | 200 tokens | 20 200 | 101 fois |
Risques
Mise en place
Puis mesurer : dix cas dont vous connaissez la réponse, passés au niveau de départ et au niveau au-dessus ; ne garder le plus haut que s'il fait nettement mieux. C'est la règle d'OpenAI pour son niveau le plus élevé : seulement quand une évaluation montre un bénéfice qui justifie le temps et le coût. Pour la méthode : évaluer un outil d'IA.
Exercice
Pour chaque tâche, réflexion basse ou haute ?
- Trier les courriels entrants entre cinq services.
- Trouver pourquoi les marges d'un produit ont baissé, à partir de trois fichiers de ventes et d'achats.
- Reformuler une annonce de recrutement dans un ton plus chaleureux.
- Établir le planning de huit techniciens sur trois chantiers, avec leurs contraintes.
Ouvrir la correction
1. BasseUn classement : la réflexion n'apporte presque rien, et se paierait sur chaque courriel.
2. HauteUne analyse en plusieurs étapes, sur des données à croiser ; le calcul lui-même, à confier à un outil.
3. BasseDe l'écriture, sans problème à résoudre.
4. Haute, et à vérifierUn problème à contraintes nombreuses : la réflexion aide, mais un plan se vérifie contrainte par contrainte.
Vérification
1ComprendreUne réponse de trois lignes vous est facturée comme une page entière. Pourquoi ?
Parce que le modèle a d'abord écrit une réflexion invisible, facturée en entier comme du texte écrit, même si vous n'en voyez qu'un résumé ou rien.
2AppliquerPour classer des courriels par service, faut-il le niveau de réflexion le plus haut ?
Non : un classement n'en tire presque aucun bénéfice. Un niveau bas suffit ; ne monter que si une mesure sur vos cas montre un gain.
3ComprendreLa réflexion affichée par un assistant dit-elle exactement comment il a trouvé sa réponse ?
Non : c'est un résumé écrit après coup, pas le raisonnement lui-même. La réponse se juge sur pièces.
Lectures suivantes
Rien avant : c'est un point de départ.
Les modèles de raisonnement
Rien avant : c'est un point de départ.
Les pages qui renvoient ici
Limites et sources
Les études sur les limites de la réflexion portent sur des modèles de 2024 et 2025 ; les modèles de 2026 réfléchissent mieux, mais aucune mesure indépendante ne montre que ces limites ont disparu.
Les chiffres de réussite publiés par les éditeurs (OpenAI, DeepSeek) sont leurs propres mesures.
- OpenAI, Reasoning models ; Anthropic, Thinking ; Google, Gemini thinking ; DeepSeek-R1, Nature ; Apple, The Illusion of Thinking ; Inverse Scaling in Test-Time Compute.
- Le relevé complet :
apprendre/recherches/2026-10-08-comprendre-modeles.json.
Écrit par Meridal, avec l'aide de l'IA ; chaque fait vérifié à sa source et relu avant publication. Texte et schémas sous licence CC BY 4.0 : reprenez-les en citant Meridal. Le code sous licence MIT.
Choisir un outil ou un abonnement
275 € à 850 €