Sur cette page
Répondez de tête, puis ouvrez. Le modèle de langage
1D'où vient ce que sait un modèle quand vous lui posez une question ?
De ce qu'il a lu pendant son entraînement, arrêté à une date, et de ce qu'on met sous ses yeux dans la conversation. Rien d'autre : il ne connaît pas vos documents, sauf si on les lui donne.
2Vous demandez à un assistant la règle en vigueur depuis le mois dernier. Que faire pour avoir une réponse fiable ?
Activer la recherche sur le web ou joindre le texte de la règle : ses connaissances s'arrêtent avant ; puis vérifier la source citée.
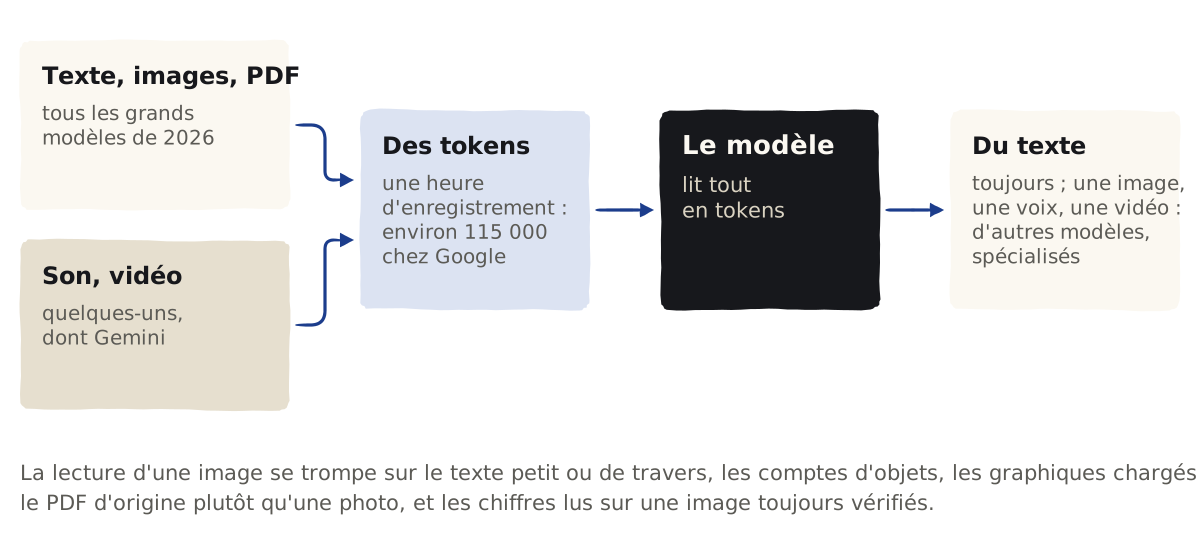
- Tous les grands modèles de 2026 lisent des images et des PDF ; seuls quelques-uns, dont Gemini, écoutent un enregistrement ou regardent une vidéo directement.
- Ils répondent toujours par du texte : fabriquer une image, une voix ou une vidéo passe par d'autres modèles, spécialisés.
- Une image, un son, une vidéo se changent en tokens, comme le texte : une heure d'enregistrement pèse environ 115 000 tokens chez Google.
- La lecture d'une image se trompe sur le texte petit ou de travers, sur les comptes d'objets, sur les graphiques chargés ; les éditeurs le disent eux-mêmes.
- Un document bien préparé se lit mieux : le PDF d'origine plutôt qu'une photo, des pages droites, et les chiffres lus sur une image toujours vérifiés.
Problème
Une facture photographiée au téléphone, l'enregistrement d'une réunion, un plan scanné, une vidéo de démonstration : une grande partie de ce qu'une entreprise reçoit n'est pas du texte. Peut-on le confier à un assistant ? Oui, souvent, mais pas à n'importe lequel, pas sous n'importe quelle forme, et pas sans vérifier.
Principe
Un modèle multimodal lit plusieurs sortes d'entrées. Il découpe une image, un son ou une vidéo en morceaux qu'il traite comme des tokens, puis écrit sa réponse comme pour un texte. Google l'écrit en chiffres : environ 100 tokens par seconde de vidéo à la résolution par défaut, 300 en haute résolution, et 32 par seconde de son.
En sortie, les grands modèles d'usage général n'écrivent que du texte : Anthropic le précise pour Claude, qui ne fabrique ni ne retouche d'image. Les images, les voix et les vidéos viennent de modèles à part : GPT Image chez OpenAI, Veo chez Google, des modèles de voix et de transcription chez les deux.
Fonctionnement
Ce que chaque modèle lit. D'après les pages des éditeurs, relevées le 8 octobre 2026. Tous lisent du texte ; « non annoncé » veut dire que l'éditeur ne le mentionne pas pour ce modèle.
Comment un PDF est lu. Claude lit chaque page à la fois comme du texte et comme une image, jusqu'à 600 pages par demande ; l'API d'OpenAI envoie elle aussi au modèle le texte extrait et l'image de chaque page. Un tableau ou un graphique dans le PDF est donc vu, pas seulement lu.
Comment une vidéo est lue. Gemini prend une image par seconde : un mouvement rapide ou un changement de plan bref peut lui échapper. Il accepte jusqu'à trois heures de vidéo à la résolution par défaut, une heure en haute résolution. Il entend aussi les sons qui ne sont pas des paroles, comme une sirène.
Exemple détaillé
| Une réunion d'une heure, donnée à Gemini | Tokens par seconde | Pour une heure |
|---|---|---|
| L'enregistrement du son | 32 | 115 200 |
| La vidéo, résolution par défaut | environ 100 | environ 360 000 |
| La vidéo, haute résolution | environ 300 | environ 1 000 000, la fenêtre entière |
Une facture photographiée de travers. Le modèle la lit comme une image. Anthropic prévient qu'il peut se tromper sur une image de mauvaise qualité, tournée, ou de moins de 200 pixels ; OpenAI cite le texte petit ou tourné et les graphiques aux couleurs ou aux traits variés parmi les limites de ses modèles. Une photo droite et nette évite les deux premiers pièges ; le PDF envoyé par le fournisseur, produit par son logiciel, contient en plus son texte, que le modèle lit avec l'image. Les montants, eux, se vérifient dans tous les cas : faire sortir les chiffres d'un document.
Risques
Mise en place
- Le PDF d'origine plutôt qu'une photo : un PDF produit par un logiciel contient son texte, lu en plus de l'image ; un scan ou une photo n'est qu'une image.
- Des pages droites et nettes : Anthropic conseille de remettre les pages à l'endroit avant de les envoyer.
- Le son plutôt que la vidéo quand seules les paroles comptent : trois fois moins de tokens.
- Le bon modèle : pour un enregistrement, un modèle qui écoute, ou une transcription d'abord ; Claude et GPT-6 Astra ne prennent pas le son directement.
- Les chiffres vérifiés : tout montant, toute date lus sur une image se contrôlent, par une règle ou par une personne.
- Les personnes informées : un enregistrement contient des voix et des noms ; prévenez les participants avant d'enregistrer, et voyez le RGPD.
Exercice
Pour chaque besoin, quelle forme donner, et à quel modèle ? Les situations sont fabriquées pour l'exercice.
- Le compte rendu d'une réunion de deux heures, enregistrée en vidéo.
- Le nombre de cartons sur la photo d'un quai de chargement.
- Les montants de trente factures reçues en photo par messagerie.
- Dix visuels pour les réseaux, avec le logo et les couleurs de l'entreprise.
Ouvrir la correction
1. Le son seulÀ un modèle qui écoute, comme Gemini, ou après une transcription : la vidéo coûterait trois fois plus sans rien ajouter au compte rendu.
2. Pas à un assistantLes comptes d'objets sont approximatifs : un inventaire se compte autrement.
3. Le PDF d'origine, si possibleSinon des photos droites et nettes ; puis les montants vérifiés par des règles : sommes, taux de TVA.
4. Pour des essais seulementUn modèle d'image peine à garder une marque cohérente d'un visuel à l'autre.
Vérification
1ComprendrePourquoi une facture photographiée de travers donne-t-elle plus d'erreurs que le PDF envoyé par le fournisseur ?
Parce que le modèle la lit seulement comme une image, et que les éditeurs signalent ses erreurs sur le texte petit ou tourné ; le PDF d'origine contient en plus son texte.
2ComprendreUn assistant peut-il dire si une image a été fabriquée par une IA ?
Non : Anthropic le dit pour Claude. Le filigrane de Google ne marque que les images de Google.
3AppliquerPour le compte rendu d'une réunion filmée, que donner au modèle ?
Le son seul, à un modèle qui écoute ou après une transcription : trois fois moins de tokens que la vidéo, pour le même compte rendu.
Lectures suivantes
Rien avant : c'est un point de départ.
L'IA multimodale
Rien avant : c'est un point de départ.
Les pages qui renvoient ici
Limites et sources
Le tableau dit ce que les éditeurs annoncent pour chaque modèle ; il ne mesure pas la qualité de la lecture, qu'aucun classement indépendant ne compare encore sur des documents d'entreprise français.
Les règles de comptage des tokens sont celles de Google pour Gemini ; chaque éditeur compte à sa façon.
- Anthropic, Vision ; Anthropic, PDF support ; OpenAI, Images and vision ; OpenAI, File inputs ; Google, Video understanding ; Google, Audio understanding ; Google, Veo.
- Le relevé complet :
apprendre/recherches/2026-10-08-comprendre-modeles.json; le tableau litapprendre/donnees/marche.json.
Écrit par Meridal, avec l'aide de l'IA ; chaque fait vérifié à sa source et relu avant publication. Texte et schémas sous licence CC BY 4.0 : reprenez-les en citant Meridal. Le code sous licence MIT.
Préparer les documents qui reviennent
1 650 € à 5 100 €, puis sur devis