Sur cette page
Répondez de tête, puis ouvrez. Faire tourner un modèle chez soi
1Qu'est-ce qui décide qu'un modèle tient sur une machine ?
Sa taille à la quantification choisie, plus le cache de la fenêtre de contexte et des demandes simultanées, plus le système : la mémoire graphique ou unifiée doit contenir le tout.
2Pourquoi un serveur de modèles installé chez soi n'est-il pas sûr de lui-même ?
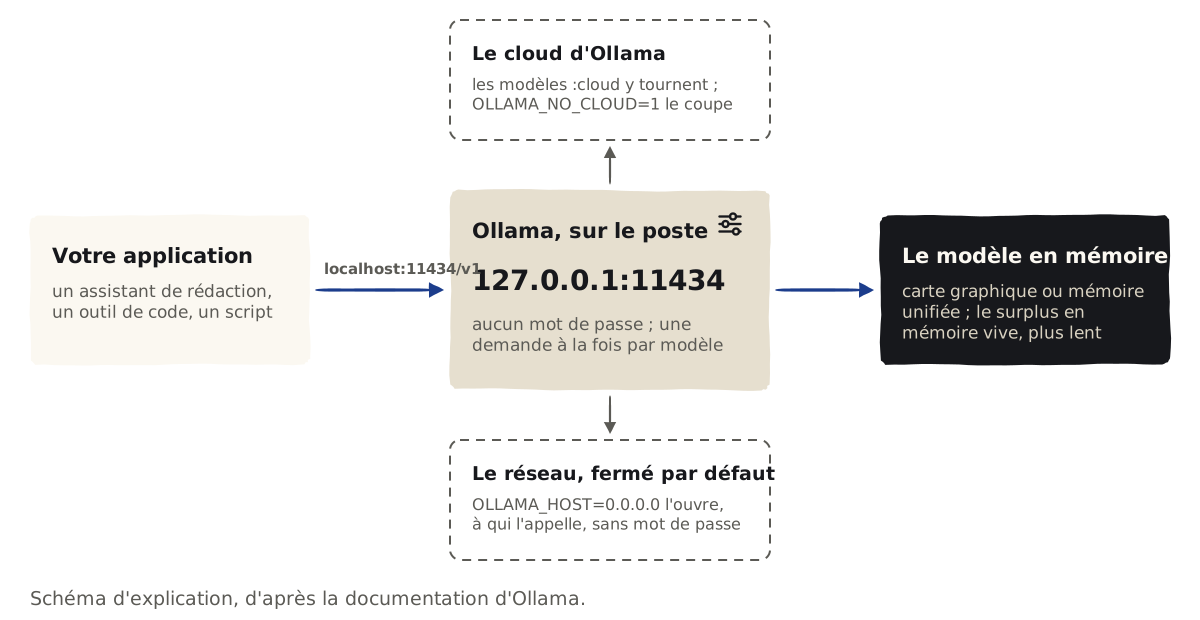
Parce qu'il n'a pas de mot de passe par défaut : ouvert au réseau, ou publié par Docker, il répond à qui l'appelle ; et ses failles se corrigent par des mises à jour qu'il faut faire.
- Ollama, gratuit sous licence MIT, fait tourner un modèle open weight sur un Mac, un PC ou un serveur ; LM Studio fait de même avec une interface, gratuit au travail depuis juillet 2025.
- Le modèle se choisit par la mémoire : son fichier, plus le cache de la conversation, doivent tenir dans la carte graphique ou la mémoire unifiée ; au-delà, Ollama déborde sur la mémoire vive et ralentit.
- La fenêtre de contexte par défaut est courte sous 24 Go de mémoire graphique, 4 000 tokens ; Ollama en conseille 64 000 pour les agents et les outils de code.
- Le serveur n'a pas de mot de passe : il doit rester sur la machine. Et certains modèles de la bibliothèque, marqués cloud, tournent chez Ollama, pas chez vous.
- Des failles critiques se corrigent par les mises à jour ; la dernière version stable d'Ollama est la 0.40.1, du 7 octobre 2026.
Prérequis
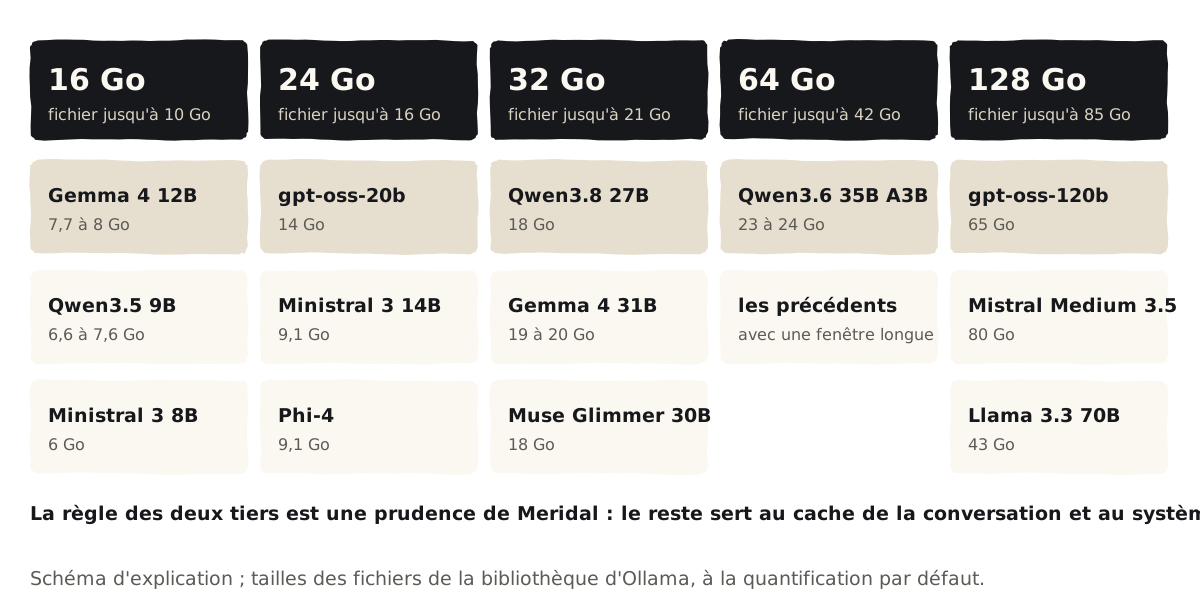
- Les tailles sont celles des fichiers de la bibliothèque d'Ollama, à la quantification par défaut, Q4_K_M pour la plupart. La qualité de chacun face aux modèles fermés : faire tourner un modèle chez soi.
- Le français : gpt-oss a été entraîné sur des textes surtout anglais ; Gemma 4 couvre plus de 140 langues, et IBM a testé Granite 4.2 en français.
- Les licences : Gemma 4, Qwen, gpt-oss et Ministral 3 sont sous Apache 2.0 ; celle de Mistral Medium 3.5 exclut les entreprises de plus de 20 millions de dollars de chiffre d'affaires mensuel.
- Les données : en local, Ollama dit ne voir ni les demandes ni les données ; LM Studio fonctionne hors connexion, sauf pour télécharger les modèles et les mises à jour.
Étapes
terminalcurl -fsSL https://ollama.com/install.sh | sh
Ou le fichier Ollama.dmg, téléchargé sur le site d'Ollama. Depuis la version 0.40.0, les modèles dont l'architecture le permet tournent sur MLX, le moteur d'Apple, sur les puces Apple.
Couper le cloud, si les données ne doivent pas sortir
Ce qu'on obtient : la variable
OLLAMA_NO_CLOUD=1, puis un redémarrage : les fonctions en ligne d'Ollama sont coupées. Ollama se règle par ces variables, posées comme ci-dessous selon le système.À vérifier : le journal du serveur affiche « Ollama cloud disabled: true »
terminal# pour chaque réglage, puis quitter et relancer l'application Ollama launchctl setenv OLLAMA_NO_CLOUD "1" launchctl setenv OLLAMA_CONTEXT_LENGTH "64000"
Quittez Ollama, ajoutez la variable dans les variables d'environnement de votre compte Windows, par exemple OLLAMA_NO_CLOUD égale à 1, puis relancez Ollama.
terminalsudo systemctl edit ollama.service # ajouter sous [Service] : # Environment="OLLAMA_NO_CLOUD=1" # Environment="OLLAMA_CONTEXT_LENGTH=64000" sudo systemctl daemon-reload sudo systemctl restart ollama
Télécharger un modèle à la taille de la machine
Ce qu'on obtient :
ollama pull gemma4:12bpour un poste de 16 Go ;ollama lsliste les modèles présents. Sans étiquette, Ollama prend la taille par défaut de la famille.À vérifier : les étiquettes qui finissent par cloud, comme
gemma4:31b-cloud, tournent sur les serveurs d'Ollama.Converser, puis regarder où le modèle tourne
Ce qu'on obtient :
ollama run gemma4:12bouvre une conversation ; dans un autre terminal,ollama psmontre le modèle chargé, sa taille, sa fenêtre de contexte et sa part sur la carte graphique.À vérifier : 100 % sur la carte graphique ; un partage, par exemple 48 % sur le processeur et 52 % sur la carte, veut dire un modèle trop grand pour la machine, et lent
Élargir la fenêtre de contexte
Ce qu'on obtient : la variable
OLLAMA_CONTEXT_LENGTH, par exemple 64000, pour tout le serveur ; ou/set parameter num_ctxdans une conversation.À vérifier : chaque hausse prend de la mémoire : relancez
ollama pspour voir si le modèle tient toujours sur la carteBrancher une application
Ce qu'on obtient : l'adresse
http://localhost:11434/v1, à la place de celle d'OpenAI dans l'outil. La clé demandée par l'outil peut valoir n'importe quoi : Ollama l'ignore.À vérifier : cette adresse ne permet pas de régler la fenêtre de contexte : il faut un Modelfile, ci-dessous.
Modelfile# Modelfile : un modèle à fenêtre de 32 000 tokens, pour les applications FROM gemma4:12b PARAMETER num_ctx 32768
terminalollama create gemma4-32k -f ./Modelfile ollama run gemma4-32k
terminal, appel d'essaicurl http://localhost:11434/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{"model": "gemma4:12b", "messages": [{"role": "user", "content": "Bonjour"}]}'Garder le serveur sur la machine
Ce qu'on obtient : ne pas changer
OLLAMA_HOST; avec Docker, publier le port par-p 127.0.0.1:11434:11434. Le serveur répond sans mot de passe à qui peut l'atteindre.À vérifier : si d'autres postes doivent l'appeler, qu'un technicien le place derrière une authentification. LeakIX a compté 12 269 serveurs Ollama ouverts sans authentification, dont 1 425 en France.
Tenir à jour
Ce qu'on obtient : la dernière version stable, 0.40.1 au 7 octobre 2026 ; sur Linux, la commande d'installation met à jour.
À vérifier : une mesure sur un an n'a vu que 0,43 à 2,90 % des serveurs exposés et vulnérables mis à jour sur place. Les failles, plus bas, dans les problèmes fréquents
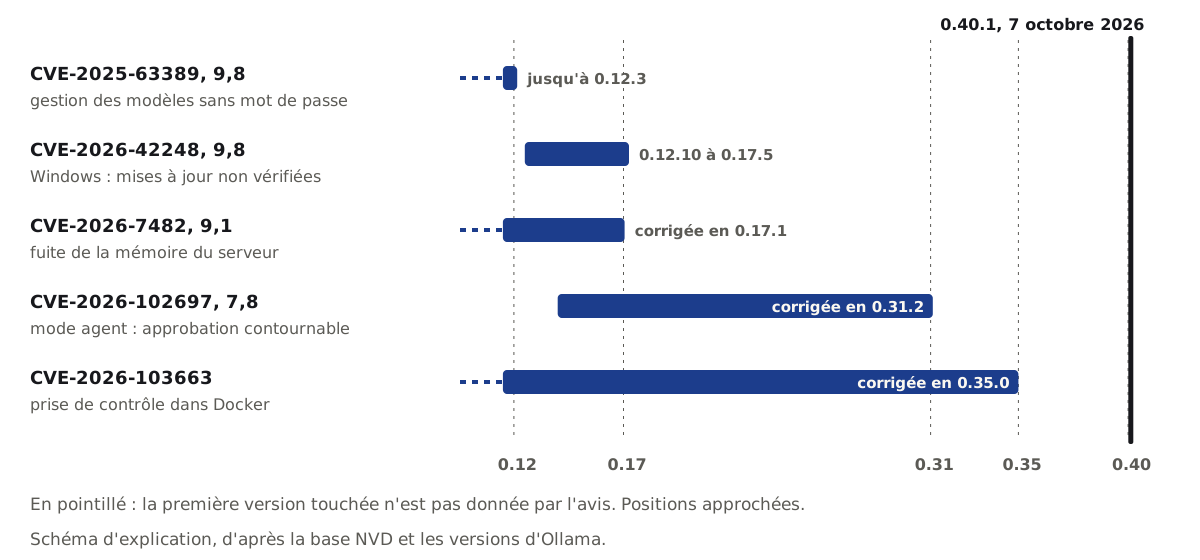
Les avis de sécurité : CVE-2025-63389, CVE-2026-42248, CVE-2026-7482, CVE-2026-102697, CVE-2026-103663, dans la base NVD.
Contrôle du résultat
Problèmes fréquents
Les réponses sont très lentes
CauseLe modèle déborde de la carte graphique sur le processeur.
À faireollama ps le montre ; prenez un modèle plus petit, ou une fenêtre plus courte.
Le modèle oublie le début d'un long document
CauseLa fenêtre de contexte par défaut est de 4 000 tokens sous 24 Go de mémoire graphique.
À faireÉlargissez-la par OLLAMA_CONTEXT_LENGTH, ou par un Modelfile pour les applications.
Le réglage de contexte de l'application n'a pas d'effet
CauseL'adresse compatible OpenAI ne permet pas de le changer.
À faireUn Modelfile avec PARAMETER num_ctx, puis ollama create.
Plusieurs personnes attendent leur tour
CauseOllama traite une demande à la fois par modèle, par défaut.
À faireOLLAMA_NUM_PARALLEL en accepte plus ; la mémoire grandit d'autant.
Dans Docker, sur un Mac, tout est lent
CauseDocker Desktop sur macOS ne donne pas accès à la puce graphique.
Le modèle voulu n'est pas dans la bibliothèque
CauseMistral Small 4, par exemple, n'y est pas.
À faireDes fichiers GGUF de la communauté existent sur Hugging Face ; Ollama les importe sans les recompresser.
Une version ancienne tourne encore
CauseDes failles critiques sont corrigées : CVE-2026-7482, fuite de mémoire, notée 9,1 sur 10, avant 0.17.1 ; CVE-2026-103663, écriture de fichier menant à la prise de contrôle dans Docker, avant 0.35.0.
À faireMettez à jour ; sur Windows, les versions 0.12.10 à 0.17.5 ne vérifiaient pas la signature des mises à jour téléchargées.
Retour en arrière
- Libérer la mémoire : un modèle reste chargé cinq minutes après usage ;
ollama stople décharge tout de suite. - Libérer le disque :
ollama rmsupprime un modèle. Les fichiers sont dans~/.ollama/modelssur Mac,/usr/share/ollama/.ollama/modelssur Linux, le dossier.ollama\modelsdu compte sur Windows. - Refermer le serveur : retirer la variable
OLLAMA_HOSTet redémarrer ; avec Docker, recréer le conteneur en publiant le port sur 127.0.0.1 seulement. - Rendre au cloud : retirer
OLLAMA_NO_CLOUDet redémarrer.
terminalollama stop gemma4:12b # décharger le modèle de la mémoire ollama rm gemma4:12b # supprimer le fichier du disque
Variantes par outil
- Ce que c'est : une application avec interface, version 0.4.26 du 8 octobre 2026 ; elle fait tourner les modèles par llama.cpp, et par MLX sur les puces Apple.
- La licence : gratuite pour un usage personnel ou interne à l'entreprise ; interdite pour servir des tiers ; application fermée, outil en ligne de commande
lmssous licence MIT. - Les modèles : téléchargés depuis Hugging Face ; LM Studio conseille une quantification de 4 bits ou plus. En ligne de commande :
lms get, puislms load. - Le serveur : l'onglet Developer, ou
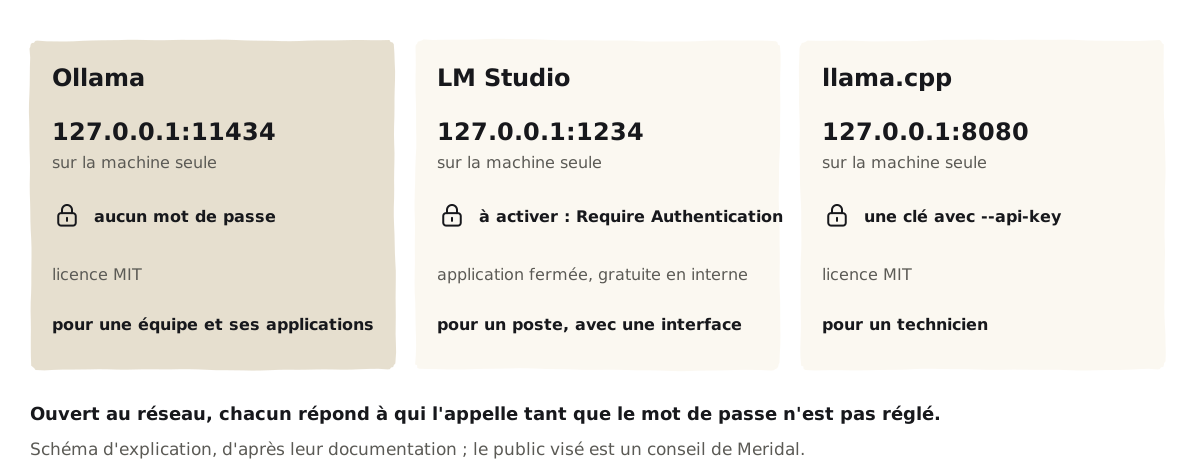
lms server start; port 1234, sur la machine seule par défaut, sans authentification. - Le réseau : le réglage « Serve on Local Network », ou
--bind 0.0.0.0, ouvre le serveur ; LM Studio recommande alors « Require Authentication », avec des clés d’accès. Libellés anglais de sa documentation.
- Ce que c'est : le moteur de LM Studio sur Mac, Windows et Linux ; sous licence MIT, publié en versions numérotées, b11514 le 8 octobre 2026.
- Le serveur :
llama-serverécoute sur 127.0.0.1, port 8080, sans clé tant que--api-keyn'est pas donnée. - Les failles : CVE-2026-34159, notée 9,8, prise de contrôle par le module RPC, qui répartit le calcul entre machines, corrigée en b8492 ; CVE-2026-21869, notée 9,8, sans correctif à sa publication.
- Pour qui : un technicien qui veut tout régler ; pour une équipe, Ollama ou LM Studio suffisent.
terminaldocker run -d -v ollama:/root/.ollama -p 127.0.0.1:11434:11434 --name ollama ollama/ollama
- La commande de la documentation publie le port par
-p 11434:11434, sur toutes les interfaces ; l'image écoute sur 0.0.0.0 dans le conteneur. La version ci-dessus garde le port sur la machine. - Les cartes NVIDIA : ajouter
--gpus=all, avec l'outil de conteneurs de NVIDIA installé. - Sur Mac : pas d'accès à la puce graphique ; préférez l'application.
Vérification
1ComprendreQue montre ollama ps, et pourquoi le regarder après chaque réglage ?
Le modèle chargé, sa taille, sa fenêtre de contexte et sa part sur la carte graphique. Un partage avec le processeur veut dire un modèle trop grand pour la machine, donc lent.
2ComprendrePourquoi une application branchée sur Ollama peut-elle oublier le début d'un long document ?
La fenêtre par défaut est de 4 000 tokens sous 24 Go de mémoire graphique, et l'adresse compatible OpenAI ne permet pas de la changer : il faut OLLAMA_CONTEXT_LENGTH ou un Modelfile.
3AppliquerUn collègue a lancé Ollama dans Docker, sur un serveur du bureau, avec la commande de la documentation. Que vérifiez-vous ?
Que le port n'est pas publié sur toutes les interfaces : sans mot de passe, tout le réseau l'appelle ; le republier sur 127.0.0.1, ou le placer derrière une authentification. Puis la version : la 0.35.0 au moins corrige une faille menant à la prise de contrôle dans Docker.
Lectures suivantes
Rien avant : c'est un point de départ.
Ollama et LM Studio : mise en place
Rien avant : c'est un point de départ.
Les pages qui renvoient ici
Limites et sources
Les commandes viennent de la documentation d'Ollama, de LM Studio, de llama.cpp et de Docker, lue le 9 octobre 2026 ; Meridal n'a installé ni Ollama ni LM Studio pour cette page.
La règle des deux tiers de la mémoire est une prudence de Meridal, pas une mesure : ollama ps tranche.
La foire aux questions d'Ollama annonce encore 4 096 tokens de contexte par défaut ; sa page sur la fenêtre de contexte et son code donnent une valeur selon la mémoire graphique. La page suit le code.
Leur documentation est en anglais ; les libellés cités le sont aussi.
- Ollama, foire aux questions ; Ollama, la fenêtre de contexte ; Ollama, compatibilité OpenAI ; LM Studio, servir sur le réseau ; LM Studio, conditions d'utilisation ; LeakIX, serveurs Ollama exposés.
- Le relevé :
apprendre/recherches/2026-10-09-modele-chez-soi.json.
Écrit par Meridal, avec l'aide de l'IA ; chaque fait vérifié à sa source et relu avant publication. Texte et schémas sous licence CC BY 4.0 : reprenez-les en citant Meridal. Le code sous licence MIT.
L'IA pour toute l'équipe
1 650 € à 4 250 €, puis sur devis