Sur cette page
Répondez de tête, puis ouvrez. Les modèles open weight et les modèles fermés
1Un modèle open weight est-il open source ?
Pas forcément. L'Open Source Initiative exige aussi des informations détaillées sur les données d'entraînement et le code complet ; un modèle open weight peut ne publier que ses paramètres.
2Que permet un modèle open weight qu'un modèle fermé ne permet pas ?
Le faire tourner sur vos serveurs ou chez l'hébergeur de votre choix : vos textes restent où vous le décidez, et personne ne peut vous retirer le modèle.
- Ce qui tient sur une machine de 32 Go reste loin des modèles payants : le meilleur, Qwen3.8 27B, obtient 34 à l'indice d'Artificial Analysis ; le petit Claude Haiku 5.5, 43 ; le meilleur modèle, 58.
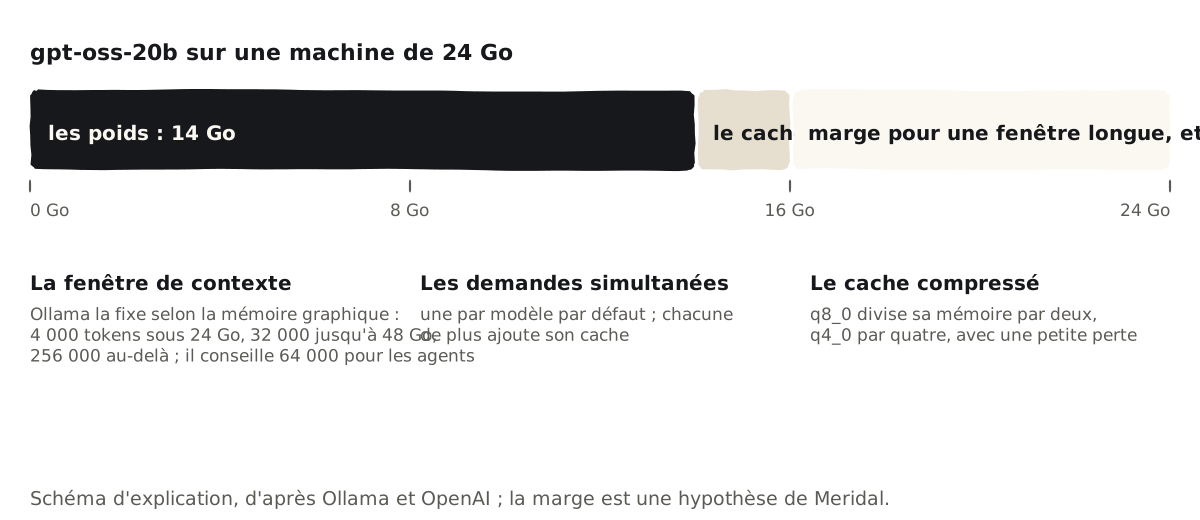
- La mémoire décide : gpt-oss-20b demande 16 Go, gpt-oss-120b 80 Go ; « Mistral Small 4 » compte 119 milliards de paramètres et pèse 72 Go à 4 bits.
- Acheter coûte vite : un Mac Studio de 96 Go, 6 599 € TTC ; une carte RTX PRO 6000 de 96 Go, 19 370 € chez LDLC. Louer une carte en France commence vers 0,75 € hors taxes de l'heure.
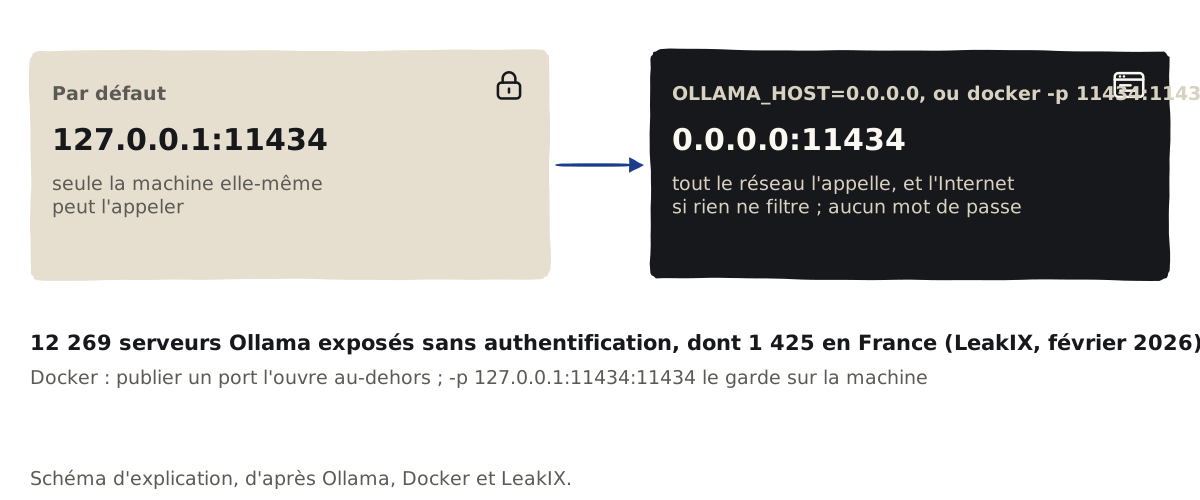
- Un serveur de modèles n'a pas de mot de passe par défaut : LeakIX en a compté 12 269 ouverts sur l'Internet, dont 1 425 en France.
- La CNIL juge l'installation chez soi généralement plus appropriée pour des données personnelles ou sensibles ; l'ANSSI demande un hébergement de confiance et un mode dégradé.
La qualité selon la taille
La qualité des modèles open weight, selon la mémoire qu'ils demandent
Voir en tableau
| Modèle | Téléchargement | Indice |
|---|---|---|
| Qwen3.8 27B | 18 Go | 34 |
| Qwen3.6 35B A3B | 23,5 Go | 18 |
| Muse Glimmer 30B | 18 Go | 17 |
| Gemma 4 26B A4B | 17,5 Go | 17 |
| Gemma 4 31B | 19,5 Go | 15 |
| Granite 4.2 30B | 18 Go | 15 |
| Gemma 4 12B | 7,85 Go | 14 |
| Qwen3.5 9B | 7,1 Go | 11 |
| Granite 4.2 8B | 5,3 Go | 11 |
| gpt-oss-20b | 14 Go | 10 |
| Mistral Medium 3.5 | 80 Go | 14 |
| gpt-oss-120b | 65 Go | 12 |
| Mistral Small 4 | 72,1 Go | 11 |
| Llama 4 Scout | 67 Go | 8 |
| Llama 4 Maverick | 245 Go | 10 |
Options
- Un poste puissant : un Mac à grande mémoire unifiée, ou un PC avec une carte graphique ; Ollama ou LM Studio pour faire tourner le modèle. Pour une ou quelques personnes. La mise en place : Ollama et LM Studio.
- Un serveur dans l'entreprise : une ou plusieurs cartes de 48 à 96 Go, et un serveur comme vLLM pour plusieurs personnes à la fois ; sous Linux, cartes NVIDIA récentes.
- Un serveur loué en Europe : une machine à carte graphique chez Scaleway ou OVHcloud, à l'heure ; vous y installez le modèle, et vous le tenez.
- Une API de modèles ouverts, en Europe : l'hébergeur fait tourner le modèle et facture au token ; rien à tenir, mais vos textes sortent chez lui. Le détail : les modèles sur un cloud européen.
Sélection par besoin
| Situation | Choix | Pourquoi |
|---|---|---|
| Des documents qui ne doivent pas sortir, une ou deux personnes | Un poste puissant | rien ne sort ; qualité à essayer sur vos cas |
| Des documents qui ne doivent pas sortir, toute une équipe | Un serveur dans l'entreprise | plusieurs demandes à la fois ; quelqu'un pour le tenir |
| Un essai, sans acheter de matériel | Un serveur loué, à l'heure | on l'éteint après ; quelques euros |
| Un traitement en volume, données hébergées en France | Une API de modèles ouverts | le moins cher par document ; un contrat de sous-traitance |
| Des données de santé, ou des exigences de l'État | Un hébergeur certifié HDS, ou qualifié SecNumCloud | les API d'IA de Scaleway et d'OVHcloud ne sont pas dans leurs listes HDS |
| La meilleure qualité possible | Un modèle fermé, sous contrat | aucun modèle ouvert sur poste n'approche les meilleurs |
Certifications HDS et SecNumCloud : listes des hébergeurs lues le 9 octobre 2026.
Comparatif
Prix lus le 9 octobre 2026 : Apple et LDLC toutes taxes comprises, Scaleway et OVHcloud hors taxes. Aucune mesure indépendante de vitesse sur ces machines n'a été trouvée.
Méthode
- Essayer avant d'acheter : la même tâche, sur dix cas réels, avec le modèle ouvert visé, par une API ou un serveur loué à l'heure, et avec un modèle fermé ; comparer.
- Choisir la machine d'après le modèle : la taille du fichier, plus le cache de la fenêtre voulue, plus une marge.
- Lire la licence du modèle : Apache 2.0 ou MIT pour la plupart ; celle de Mistral Medium 3.5 exclut les entreprises au-delà de 20 millions de dollars de revenu mensuel.
- Télécharger des formats sûrs, comme safetensors, et proscrire pickle, comme le demande l'ANSSI ; un modèle peut contenir du code malveillant, rappelle le CERT-FR.
- Garder le serveur sur la machine ou le réseau interne, journaliser, et prévoir de travailler sans lui.
- Mettre à jour : la plupart des serveurs exposés tournent avec des versions vulnérables, rarement mises à jour.
Pièges de lecture
Vérification
1ComprendreQu'est-ce qui décide qu'un modèle tient sur une machine ?
Sa taille à la quantification choisie, plus le cache de la fenêtre de contexte et des demandes simultanées, plus le système : la mémoire graphique ou unifiée doit contenir le tout.
2ComprendrePourquoi un serveur de modèles installé chez soi n'est-il pas sûr de lui-même ?
Parce qu'il n'a pas de mot de passe par défaut : ouvert au réseau, ou publié par Docker, il répond à qui l'appelle ; et ses failles se corrigent par des mises à jour qu'il faut faire.
3AppliquerUne PME veut résumer des dossiers clients qui ne doivent pas sortir, pour trois personnes. Que proposez-vous ?
Essayer d'abord un modèle ouvert sur dix dossiers, par un serveur loué à l'heure ; puis un poste à grande mémoire avec Ollama, le serveur gardé sur la machine, si la qualité suffit.
Lectures suivantes
Un modèle hébergé chez soi
Rien avant : c'est un point de départ.
Limites et sources
La qualité vient d'un indice de tiers, en anglais surtout ; essayez sur vos propres cas, en français.
Les tailles sont celles des fichiers d'Ollama ; la mémoire nécessaire est plus grande. Aucune mesure indépendante de vitesse sur ces machines n'a été trouvée.
Les prix de matériel sont ceux des boutiques lues le 9 octobre 2026 ; ceux des cartes graphiques bougent beaucoup.
- Artificial Analysis ; LMArena ; Compar:IA ; ANSSI, recommandations pour un système d'IA générative ; CNIL, IA générative ; LeakIX, serveurs Ollama exposés.
- Le relevé :
apprendre/recherches/2026-10-09-modele-chez-soi.json.
Écrit par Meridal, avec l'aide de l'IA ; chaque fait vérifié à sa source et relu avant publication. Texte et schémas sous licence CC BY 4.0 : reprenez-les en citant Meridal. Le code sous licence MIT.
Choisir vos outils
275 € à 850 €