Sur cette page
Répondez de tête, puis ouvrez. Faire tourner un modèle chez soi
1Qu'est-ce qui décide qu'un modèle tient sur une machine ?
Sa taille à la quantification choisie, plus le cache de la fenêtre de contexte et des demandes simultanées, plus le système : la mémoire graphique ou unifiée doit contenir le tout.
2Une PME veut résumer des dossiers clients qui ne doivent pas sortir, pour trois personnes. Que proposez-vous ?
Essayer d'abord un modèle ouvert sur dix dossiers, par un serveur loué à l'heure ; puis un poste à grande mémoire avec Ollama, le serveur gardé sur la machine, si la qualité suffit.
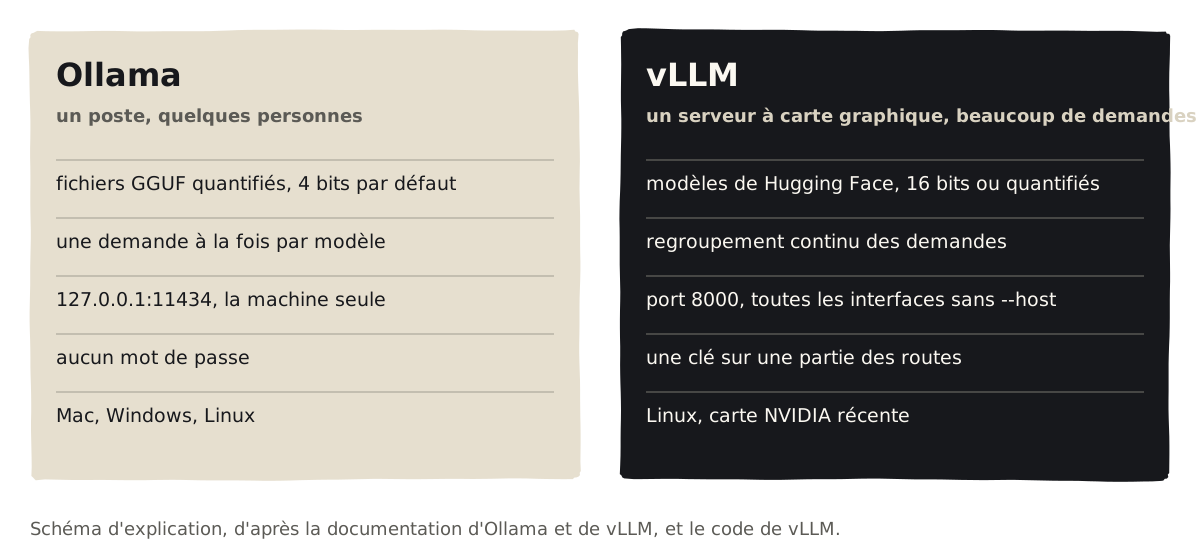
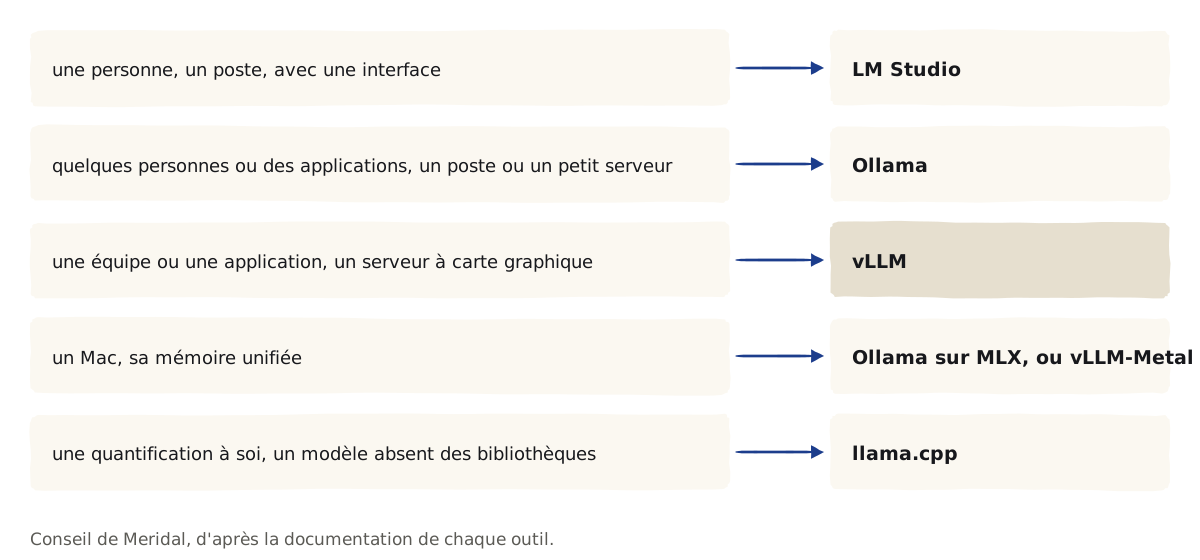
- Ollama sert un poste ou quelques personnes, une demande à la fois par modèle ; vLLM sert un serveur à carte graphique, en regroupant les demandes en continu.
- Quantifier, c'est ranger chaque poids sur moins de bits : Llama 3.1 8B passe de 14,96 Gio en 16 bits à 4,58 Gio en Q4_K_M, et génère près de 2,5 fois plus vite dans la mesure de llama.cpp.
- La perte reste faible jusqu'à 4 bits : sur Llama 3.1, le FP8 est sans perte en pratique, l'INT8 perd 1 à 3 %, l'INT4 sur les seuls poids rivalise avec le 8 bits.
- vLLM écoute sur toutes les interfaces quand l'option
--hostmanque, et sa clé ne protège qu'une partie des routes : un proxy inverse filtre devant. - Un modèle téléchargé peut porter du code : le format safetensors, des dépôts de confiance, une version à jour.
Prérequis
- Pour vLLM : Linux, Python 3.11 à 3.14, une carte NVIDIA de capacité de calcul 7.5 ou plus, T4, RTX 20, A100, L4, H100, B200. Des variantes existent pour AMD, Intel et les puces Apple ; Windows passe par WSL.
- Pour Ollama : un Mac, un PC ou un serveur Linux ; la mise en place pas à pas : Ollama et LM Studio.
- Le modèle : sa licence, et l'accès à son dépôt ; Llama 4 Scout, par exemple, n'est donné qu'après accord manuel de Meta. Le choix du modèle selon la machine : faire tourner un modèle chez soi.
- Une carte louée, pour essayer avant d'acheter, ci-dessous ; un grand modèle demande plusieurs cartes : deux pour Mistral Small 4, huit pour Mistral Medium 3.5, dans les commandes de Mistral.
Prix hors taxes lus le 9 octobre 2026 ; chez Scaleway, la L4 en zone Paris 1, les autres en zone Paris 2. Où héberger en Europe : héberger en Europe.
Étapes
Choisir la quantification
Ce qu'on obtient : le format du modèle : GGUF pour Ollama et llama.cpp ; pour vLLM, le 16 bits d'origine, ou un modèle déjà quantifié, FP8, INT8, INT4, AWQ, GPTQ, GGUF. D'après l'étude de Kurtic et ses coauteurs, l'INT4 sur les poids est le plus économique pour des demandes une à une, le W8A8 avec beaucoup de demandes regroupées.
À vérifier : que votre carte prend le format en charge : le FP8 W8A8 demande une carte Ada, Hopper ou AMD.
La taille et la vitesse d'un modèle selon sa quantification
Voir en tableau
| Type | Bits par poids | Taille | Tokens par seconde |
|---|---|---|---|
| F16 | 16,00 | 14,96 Gio | 29,17 |
| Q8_0 | 8,50 | 7,95 Gio | 50,93 |
| Q6_K | 6,56 | 6,14 Gio | 58,67 |
| Q5_K_M | 5,70 | 5,33 Gio | 67,23 |
| Q4_K_M | 4,89 | 4,58 Gio | 71,93 |
| Q3_K_M | 4,00 | 3,74 Gio | 71,68 |
| Q2_K | 3,16 | 2,95 Gio | 79,85 |
| IQ2_XXS | 2,38 | 2,23 Gio | 79,86 |
| IQ1_S | 2,00 | 1,87 Gio | 79,73 |
- Pourquoi plus petit va plus vite : pour chaque token, la carte relit tous les poids du modèle ; moins d'octets à lire, plus de tokens par seconde, jusqu'à ce que le calcul lui-même devienne la limite, vers 80 tokens par seconde dans cette mesure.
- Ce que la quantification fait perdre : sur toute la famille Llama 3.1 et plus de 500 000 évaluations, le FP8 est sans perte en pratique, l'INT8 bien réglé perd 1 à 3 %, l'INT4 sur les seuls poids rivalise avec le 8 bits.
- Ce qu'il faut éviter : requantifier un modèle déjà quantifié, qui peut beaucoup dégrader la qualité ; mieux vaut partir du 16 bits, avec une matrice d'importance.
Installer vLLM
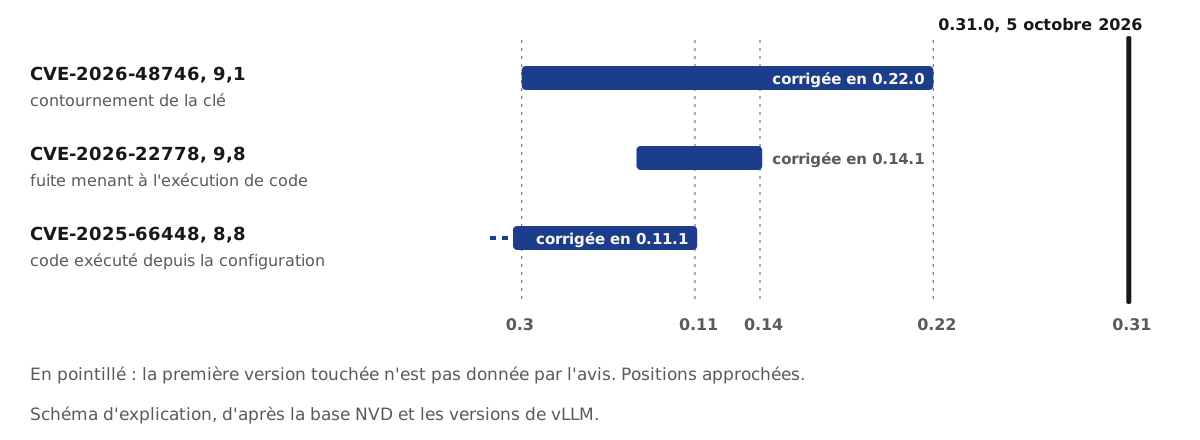
Ce qu'on obtient : un environnement Python dédié, créé avec uv, puis vLLM ; la version 0.31.0 est sortie le 5 octobre 2026.
À vérifier : que le pilote de la carte est installé : uv choisit la version de PyTorch d'après lui
Servir le modèle sur la machine seule
Ce qu'on obtient :
vllm serveavec--host 127.0.0.1: sans cette option, vLLM écoute sur toutes les interfaces, même si sa documentation parle de localhost. La clé se donne parVLLM_API_KEY.À vérifier : vLLM télécharge le modèle depuis Hugging Face, et applique les réglages recommandés par son auteur, sauf
--generation-config vllm.
terminal, installationuv venv --python 3.12 --seed source .venv/bin/activate uv pip install vllm --torch-backend=auto
terminal, serviceexport VLLM_API_KEY="$(openssl rand -hex 32)" # une clé longue, à ranger dans le coffre de l'équipe vllm serve Qwen/Qwen2.5-1.5B-Instruct \ --host 127.0.0.1 --port 8000 \ --max-model-len 16k
Régler la mémoire
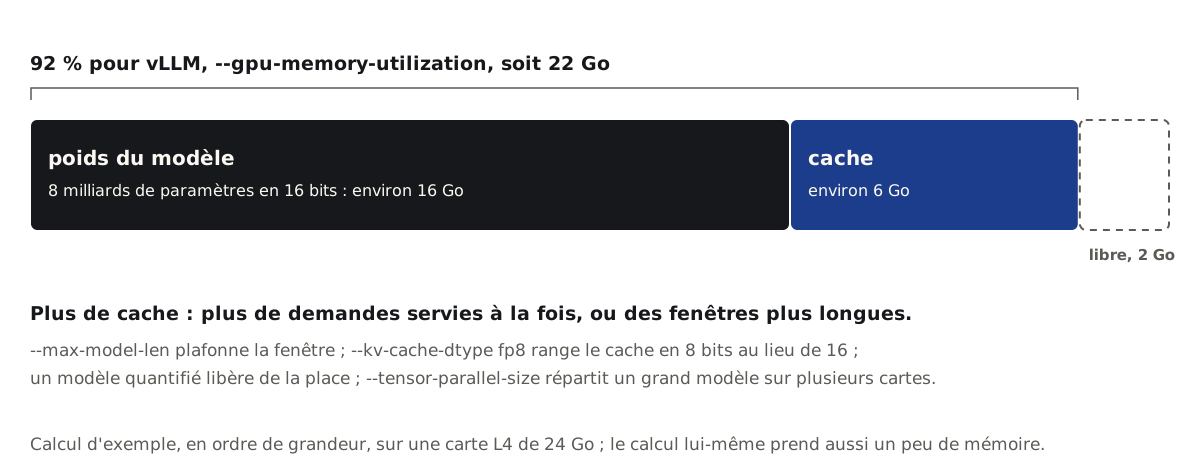
Ce qu'on obtient : vLLM prend 92 % de la mémoire de la carte par défaut ; les poids d'abord, le reste pour le cache des conversations.
--max-model-lenplafonne la fenêtre,--kv-cache-dtype fp8range le cache en 8 bits,--tensor-parallel-sizerépartit le modèle sur plusieurs cartes.À vérifier : la fenêtre réglée couvre vos plus longs documents, sans plus
terminal, appel d'essaicurl http://127.0.0.1:8000/v1/chat/completions \
-H "Authorization: Bearer $VLLM_API_KEY" \
-H "Content-Type: application/json" \
-d '{"model": "Qwen/Qwen2.5-1.5B-Instruct", "messages": [{"role": "user", "content": "Bonjour"}]}'Pythonimport os
from openai import OpenAI
client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key=os.environ["VLLM_API_KEY"])
r = client.chat.completions.create(
model="Qwen/Qwen2.5-1.5B-Instruct",
messages=[{"role": "user", "content": "Bonjour"}],
)
print(r.choices[0].message.content)Ouvrir à l'équipe derrière un proxy
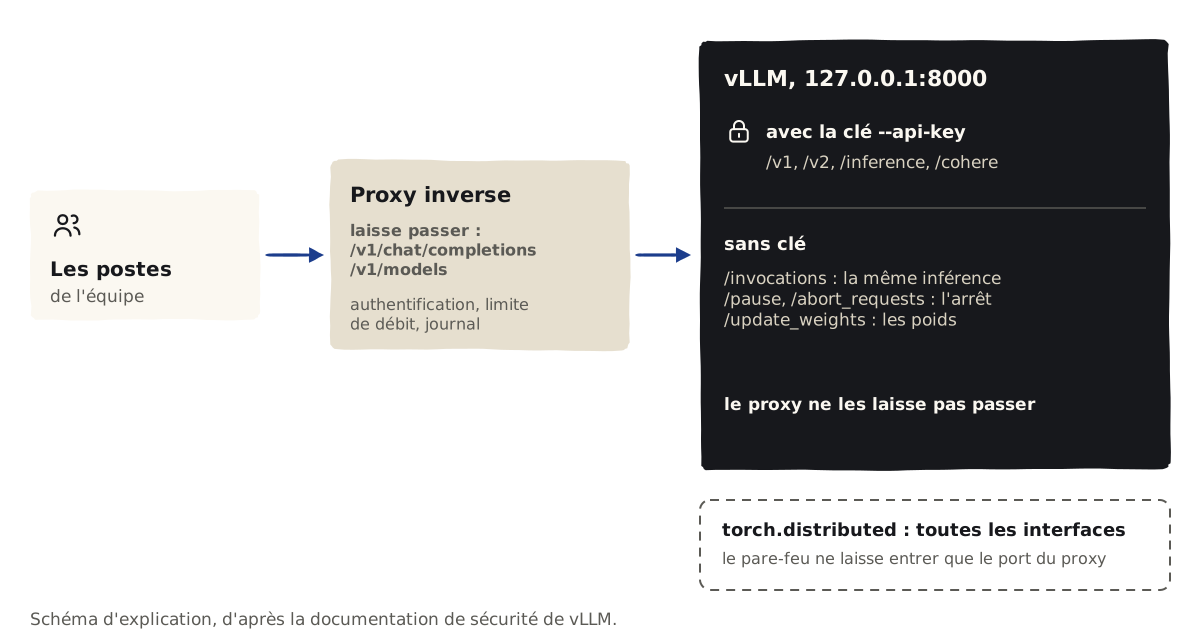
Ce qu'on obtient : un proxy inverse, nginx par exemple, qui ne laisse passer que les routes voulues et ajoute l'authentification, une limite de débit et un journal ; un pare-feu qui ne laisse entrer que son port.
À vérifier : jamais
VLLM_SERVER_DEV_MODE=1en production ;VLLM_MAX_N_SEQUENCESà 64 ou 128 si le service est public.
Tenir à jour
Ce qu'on obtient : les failles de vLLM se corrigent par version : contournement de la clé avant 0.22.0, fuite d'adresse menant à l'exécution de code avant 0.14.1, code exécuté depuis la configuration d'un modèle avant 0.11.1.
À vérifier : le cache de vLLM,
~/.cache/vllm, n'est lisible et modifiable que par son compte : vLLM le charge sans vérifier son intégrité.
Contrôle du résultat
Problèmes fréquents
vLLM refuse de démarrer faute de mémoire
CauseLes poids et le cache dépassent la part réservée de la carte.
À faireUne fenêtre plus courte par --max-model-len, un modèle quantifié, ou plusieurs cartes par --tensor-parallel-size.
Le serveur répond depuis d'autres machines
CauseL'option --host manque : vLLM écoute sur toutes les interfaces.
Des appels passent sans clé
CauseLa clé ne protège que /v1, /v2, /inference et /cohere.
À faireUn proxy inverse qui n'autorise que les routes voulues.
Les réponses ne suivent pas les réglages attendus
CausevLLM applique par défaut les réglages recommandés par l'auteur du modèle.
À faire--generation-config vllm, ou des réglages explicites dans chaque appel.
Une requête bloque le serveur
CauseLe paramètre n demande des centaines de réponses à la fois.
À faireVLLM_MAX_N_SEQUENCES, 16 384 par défaut, à 64 ou 128.
Retour en arrière
- Fermer le serveur au réseau : relancer vLLM avec
--host 127.0.0.1, retirer la règle du pare-feu qui ouvrait le port 8000. - Revenir à une version de vLLM : réinstaller la version précédente dans l'environnement, après avoir vérifié qu'elle ne porte pas de faille corrigée depuis.
- Changer de quantification : vLLM sert un seul modèle ; arrêter le service, le relancer avec l'autre version du modèle, et refaire la comparaison sur vos cas.
- Repartir d'un cache propre : supprimer
~/.cache/vllm, que vLLM recrée ; son contenu se charge sans vérification d'intégrité.
Variantes par outil
- Plusieurs demandes : une à la fois par modèle par défaut ;
OLLAMA_NUM_PARALLELen accepte plus, et la mémoire grandit d'autant ; au-delà de 512 demandes en attente, Ollama répond par une erreur 503. - Le cache :
OLLAMA_KV_CACHE_TYPE=q8_0divise sa mémoire par deux, avec une très petite perte ; q4_0, par quatre. - Un modèle absent de la bibliothèque : importer un GGUF déjà quantifié ; Ollama ne quantifie pas à l'import.
- La mise en place : Ollama et LM Studio.
terminalpython convert_hf_to_gguf.py --outfile gemma-4-E2B-it-bf16.gguf --outtype bf16 --remote google/gemma-4-E2B-it ./build/bin/llama-quantize gemma-4-E2B-it-bf16.gguf gemma-4-E2B-it-Q4_K_M.gguf Q4_K_M
- Votre propre quantification : convertir le modèle en GGUF, puis le quantifier ; l'espace GGUF-my-repo de Hugging Face le fait sans installation.
- Les images et l'audio : leur composant se garde en bf16 ou q8, car sa qualité conditionne celle des réponses.
- Le serveur :
llama-server, sur 127.0.0.1, port 8080, sans clé tant que--api-keyn'est pas donnée.
- Sans interface, sur un serveur : llmster, le service de LM Studio, s'installe par un script et démarre par
lms daemon up. - Plusieurs demandes : à la version 0.4.0, le regroupement continu venait de llama.cpp et manquait encore au moteur MLX.
- La licence : usage interne seulement, jamais un service pour des tiers.
- Ollama fait tourner sur MLX, le moteur d'Apple, les modèles dont l'architecture le permet, depuis la version 0.40.0.
- vLLM-Metal remplace PyTorch par MLX et demande des modèles préparés pour MLX, publiés par la communauté mlx-community.
- La mémoire unifiée sert de mémoire graphique : un Mac Studio monte jusqu'à 128 Go avec la puce M5 Max, 512 Go avec la M5 Ultra.
Vérification
1ComprendrePourquoi un modèle quantifié en 4 bits génère-t-il plus vite qu'en 16 bits ?
Pour chaque token, la carte relit tous les poids : un fichier trois fois plus petit se relit plus vite. Llama 3.1 8B passe de 29 à 72 tokens par seconde dans la mesure de llama.cpp.
2ComprendreQue protège la clé de vLLM, et que laisse-t-elle ouvert ?
Les routes /v1, /v2, /inference et /cohere ; /invocations, qui fait la même inférence, et des routes de contrôle comme /pause restent sans clé. D'où le proxy inverse.
3AppliquerVous servez un modèle à vingt personnes sur une carte H100 louée. Quels réglages ?
vLLM, sur 127.0.0.1, derrière un proxy inverse qui n'autorise que les routes voulues, avec authentification ; un pare-feu qui n'ouvre que le port du proxy ; un modèle en FP8 ou en W8A8, adapté aux demandes regroupées ; une fenêtre réglée au besoin ; la dernière version.
Lectures suivantes
Rien avant : c'est un point de départ.
Modèles en local : Ollama, vLLM et quantification
Les pages qui renvoient ici
Limites et sources
Les commandes viennent de la documentation de vLLM et de llama.cpp, lue le 9 octobre 2026 ; Meridal ne les a pas exécutées.
Les vitesses de llama.cpp sont mesurées sur un matériel qu'il ne précise pas : elles valent en comparaison entre elles. La perte de qualité vient d'une étude sur Llama 3.1, avec les formats de vLLM ; elle varie selon le modèle et la tâche.
La documentation de vLLM dit que le serveur démarre à localhost ; son code écoute sur toutes les interfaces sans --host. La page suit le code.
La mémoire de la carte est un calcul d'exemple, en ordre de grandeur.
- vLLM, sécurité ; vLLM, arguments de vllm serve ; vLLM, code de l'adresse d'écoute ; llama.cpp, quantification ; Kurtic et al., ACL 2025 ; ANSSI, recommandations pour un système d'IA générative.
- Les relevés :
apprendre/recherches/2026-10-09-vllm-quantification.jsonet2026-10-09-modele-chez-soi.json.
Écrit par Meridal, avec l'aide de l'IA ; chaque fait vérifié à sa source et relu avant publication. Texte et schémas sous licence CC BY 4.0 : reprenez-les en citant Meridal. Le code sous licence MIT.
Un assistant qui connaît votre entreprise
3 300 € à 10 200 €, puis sur devis