Sur cette page
Répondez de tête, puis ouvrez. Tokens, fenêtre de contexte et prix
1Pourquoi une conversation coûte-t-elle de plus en plus cher à chaque échange ?
Parce que le modèle relit tout l'historique à chaque échange : ce qu'il lit grandit à chaque tour. Le cache réduit le prix de ce qui est relu.
2Qu'est-ce qui doit tenir dans la fenêtre de contexte ?
Tout ce que le modèle lit d'un coup, instructions, documents, historique et question, et ce qu'il écrit en réponse.
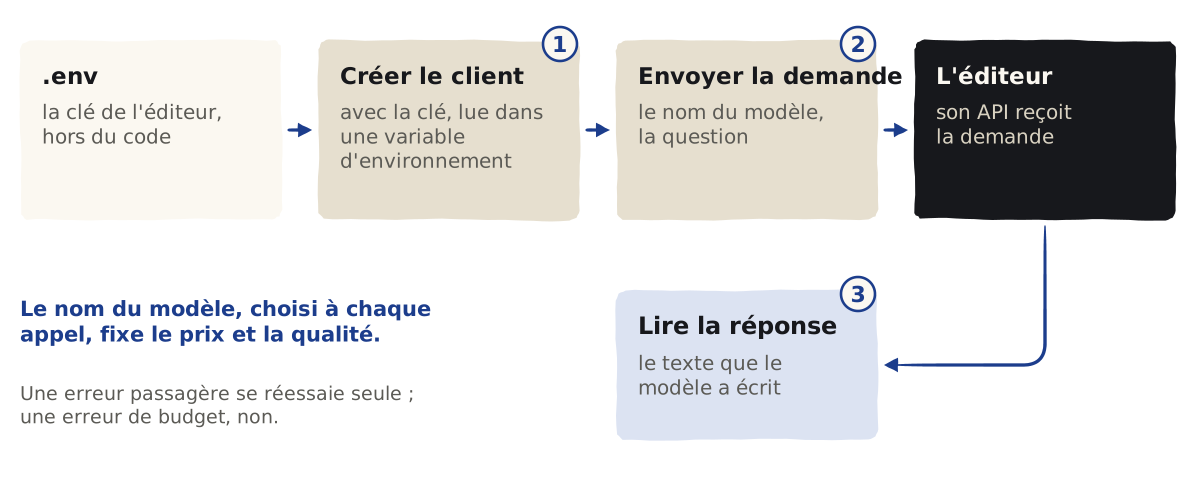
- Un appel tient en trois gestes : créer le client avec la clé, envoyer la demande, lire la réponse.
- Chaque éditeur a sa bibliothèque et sa forme de demande, mais le principe est le même.
- La clé se lit dans une variable d'environnement ; elle n'apparaît jamais dans le code.
- Le nom du modèle se choisit à chaque appel : c'est lui qui fixe le prix et la qualité.
- Les bibliothèques réessaient seules les erreurs passagères ; une erreur de budget, elle, ne passe pas en réessayant.
Objectif
Envoyer une question à un modèle depuis un programme Python, chez l'éditeur de votre choix, lire sa réponse, et savoir ce que fait chaque ligne.
Le code suit la documentation de chaque éditeur, lue le 7 octobre 2026, et les versions de leurs bibliothèques de ce jour. Il n'a pas encore été exécuté par Meridal : sa sortie n'est pas montrée.
Données fournies
Aucune : la question est dans le code. Il faut seulement une clé d'API chez l'éditeur choisi, avec un plafond de dépense.
Consignes
La bibliothèque openai, la clé dans OPENAI_API_KEY, le code de la documentation de l'éditeur, adapté sur deux points : la question en français et la lecture du fichier .env.
Terminaluv add openai python-dotenv
appel.pyfrom dotenv import load_dotenv
load_dotenv() # lit la clé dans le fichier .env
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-luna",
input="Explique en une phrase ce qu'est un token.",
)
print(response.output_text)from openai import OpenAI: importe le client de la bibliothèque d'OpenAI.client = OpenAI(): crée le client ; il lit tout seul la clé dans la variableOPENAI_API_KEY.client.responses.create(...): envoie la demande à l'API Responses, qu'OpenAI recommande pour tout nouveau projet.model="gpt-6-luna": le modèle qu'OpenAI présente pour les gros volumes à petit prix ; sa documentation prend gpt-6-astra, le plus capable.response.output_text: le texte de la réponse, tous morceaux réunis.
uv run appel.pyPas encore exécuté par Meridal. Ce qu'on attend : une phrase en français qui définit un token.
La bibliothèque anthropic, la clé dans ANTHROPIC_API_KEY, le code de la documentation de l'éditeur, adapté sur deux points : la question en français et la lecture du fichier .env.
Terminaluv add anthropic python-dotenv
appel.pyfrom dotenv import load_dotenv
load_dotenv() # lit la clé dans le fichier .env
import anthropic
client = anthropic.Anthropic()
message = client.messages.create(
model="claude-opus-5-5",
max_tokens=1000,
messages=[{"role": "user", "content": "Explique en une phrase ce qu'est un token."}],
)
for block in message.content:
if block.type == "text":
print(block.text)anthropic.Anthropic(): crée le client ; il lit la clé dansANTHROPIC_API_KEY.client.messages.create(...): envoie la demande à l'API Messages.model="claude-opus-5-5": le modèle qu'Anthropic conseille pour commencer ; Claude Haiku 5.5 coûte moins, pour les gros volumes.max_tokens=1000: le plafond de ce que le modèle écrira, obligatoire chez Anthropic : la réponse s'arrête là.messages=[...]: la conversation, ici un seul message de l'utilisateur.for block in message.content: la réponse arrive en blocs ; on n'affiche que les blocs de texte.
uv run appel.pyPas encore exécuté par Meridal. Ce qu'on attend : une phrase en français qui définit un token.
La bibliothèque google-genai, la clé dans GEMINI_API_KEY, le code de la documentation de l'éditeur, adapté sur deux points : la question en français et la lecture du fichier .env.
Terminaluv add google-genai python-dotenv
appel.pyfrom dotenv import load_dotenv
load_dotenv() # lit la clé dans le fichier .env
from google import genai
client = genai.Client()
interaction = client.interactions.create(
model="gemini-3.8-flash",
input="Explique en une phrase ce qu'est un token.",
)
print(interaction.output_text)genai.Client(): crée le client ; il lit la clé dansGEMINI_API_KEYouGOOGLE_API_KEY, la seconde l'emportant si les deux existent.client.interactions.create(...): l'API Interactions, que Google recommande pour tout nouveau projet depuis juin 2026 ; generateContent reste disponible.model="gemini-3.8-flash": le modèle stable le plus capable de Google pour le texte ; le démarrage rapide prend encore gemini-3.5-flash, que la page des modèles dit ancien.interaction.output_text: le texte de la réponse.
uv run appel.pyPas encore exécuté par Meridal. Ce qu'on attend : une phrase en français qui définit un token.
La bibliothèque mistralai, la clé dans MISTRAL_API_KEY, le code de la documentation de l'éditeur, adapté sur deux points : la question en français et la lecture du fichier .env.
Terminaluv add mistralai python-dotenv
appel.pyfrom dotenv import load_dotenv
load_dotenv() # lit la clé dans le fichier .env
import os
from mistralai.client import Mistral
client = Mistral(api_key=os.environ["MISTRAL_API_KEY"])
response = client.chat.complete(
model="mistral-large-latest",
messages=[{"role": "user", "content": "Explique en une phrase ce qu'est un token."}],
)
print(response.choices[0].message.content)from mistralai.client import Mistral: l'import des versions 2 et 3 de la bibliothèque ; l'ancienfrom mistralai import Mistralne marche plus.Mistral(api_key=...): ici, la clé se passe explicitement, lue dansMISTRAL_API_KEY.client.chat.complete(...): envoie la demande à l'API de conversation.model="mistral-large-latest": le nom que prend la documentation : un alias qui suit la dernière version du modèle.response.choices[0].message.content: le texte de la première réponse.
uv run appel.pyPas encore exécuté par Meridal. Ce qu'on attend : une phrase en français qui définit un token.
Critères de réussite
Indications
Erreur d'authentification, ou code 401
CauseLa clé n'est pas lue : fichier .env absent, nom de variable faux, ou clé révoquée.
À faireVérifiez le nom exact de la variable pour l'éditeur, et que load_dotenv() vient avant la création du client.
Erreur 429
CauseTrop de demandes à la minute, ou le budget atteint. Chez OpenAI, une erreur 429 de crédits ou de dépense ne se règle pas en réessayant ; chez Anthropic, une 429 de plafond de dépense n'a pas d'en-tête retry-after.
À faireAttendre et réessayer pour une limite de débit ; relever le plafond pour une limite de dépense.
« ImportError » avec Mistral
CauseL'ancien import des versions 1.
Correction commentée
Ouvrir la correction
Ce que les quatre programmes ont en communUn client, créé avec la clé lue dans l'environnement ; une demande, qui nomme le modèle et donne la question ; une réponse, dont on extrait le texte. Seuls les noms changent : responses.create et output_text chez OpenAI, messages.create et des blocs de texte chez Anthropic, interactions.create et output_text chez Google, chat.complete et choices[0].message.content chez Mistral.
Ce qu'on attend en sortieUne phrase en français qui définit un token, différente d'un modèle à l'autre et d'un lancement à l'autre : un modèle ne répond pas deux fois à l'identique.
Ce qui coûteQuelques dizaines de tokens lus, une ou deux centaines écrits : une fraction de centime, aux prix du marché des modèles.
Extensions
- Les erreurs : entourez l'appel d'un
try, et traitez à part la connexion, la limite de débit et les autres erreurs, comme le montre la page des erreurs d'OpenAI. - La conservation chez Google : l'API Interactions garde chaque échange par défaut, 55 jours sur l'offre payante, un jour sur l'offre gratuite ; le paramètre
storeà faux l'en empêche. - Les versions : uv fige la version de chaque bibliothèque dans
uv.lock. En mai 2026, une version piégée de la bibliothèque de Mistral volait les clés dès l'import : une version figée, et mise à jour à dessein, protège de ce genre d'accident. - La suite : faire répondre un modèle dans un format imposé, pour qu'un programme puisse lire la réponse.
Lectures suivantes
Rien avant : c'est un point de départ.
Premier appel à un modèle
Construction · étape 4 sur 12
Rien avant : c'est un point de départ.
Limites et sources
Le code suit la documentation des éditeurs et les versions de leurs bibliothèques du 7 octobre 2026 (openai 3.26.0, anthropic 1.12.0, google-genai 2.28.0, mistralai 3.1.0) ; il n'a pas encore été exécuté par Meridal.
Les noms de modèles changent souvent ; la page des modèles de chaque éditeur fait foi.
- OpenAI, Developer quickstart ; Anthropic, Get started ; Google, Gemini API quickstart ; Mistral, Send your first API request.
- Le relevé complet, avec chaque extrait de code :
apprendre/recherches/2026-10-07-dev-appels-modeles.json.
Écrit par Meridal, avec l'aide de l'IA ; chaque fait vérifié à sa source et relu avant publication. Texte et schémas sous licence CC BY 4.0 : reprenez-les en citant Meridal. Le code sous licence MIT.
Former vos équipes, et vous
Une demi-journée à deux journées, 550 € à 3 400 €