Sur cette page
- Un modèle d'embeddings transforme un texte en une liste de nombres, un vecteur ; deux textes de sens proche ont des vecteurs proches.
- Chercher, c'est comparer le vecteur de la question à ceux des passages ; avec des vecteurs de norme 1, le produit scalaire suffit.
- Passages et questions doivent passer par le même modèle : changer de modèle, c'est tout réindexer.
- Les modèles open weight les mieux classés tournent sur vos machines, gratuitement ; les modèles d'API se paient quelques centimes par million de tokens.
- Une base vectorielle range les vecteurs et retrouve vite les plus proches ; pgvector suffit souvent si l'entreprise a déjà PostgreSQL.
Problème
Une recherche par mots ne trouve que les mots tapés : « facture impayée » ne retrouve pas « relance client ». Un assistant sur vos documents doit retrouver les passages qui parlent de la même chose, même écrits autrement. C'est le rôle des embeddings, la première brique d'un RAG.
Principe
Un modèle d'embeddings lit un texte et rend un vecteur : une liste de nombres de longueur fixe, 1 024 chez mistral-embed, 1 536 ou 3 072 chez OpenAI, quelle que soit la longueur du texte. Le modèle a appris à placer près l'un de l'autre les textes de sens voisin.
Pour comparer deux vecteurs, on mesure l'angle qui les sépare : c'est la similarité cosinus. Les vecteurs d'OpenAI et de Mistral ont une norme de 1 ; le cosinus est alors un simple produit scalaire, et donne le même classement que la distance.
Fonctionnement
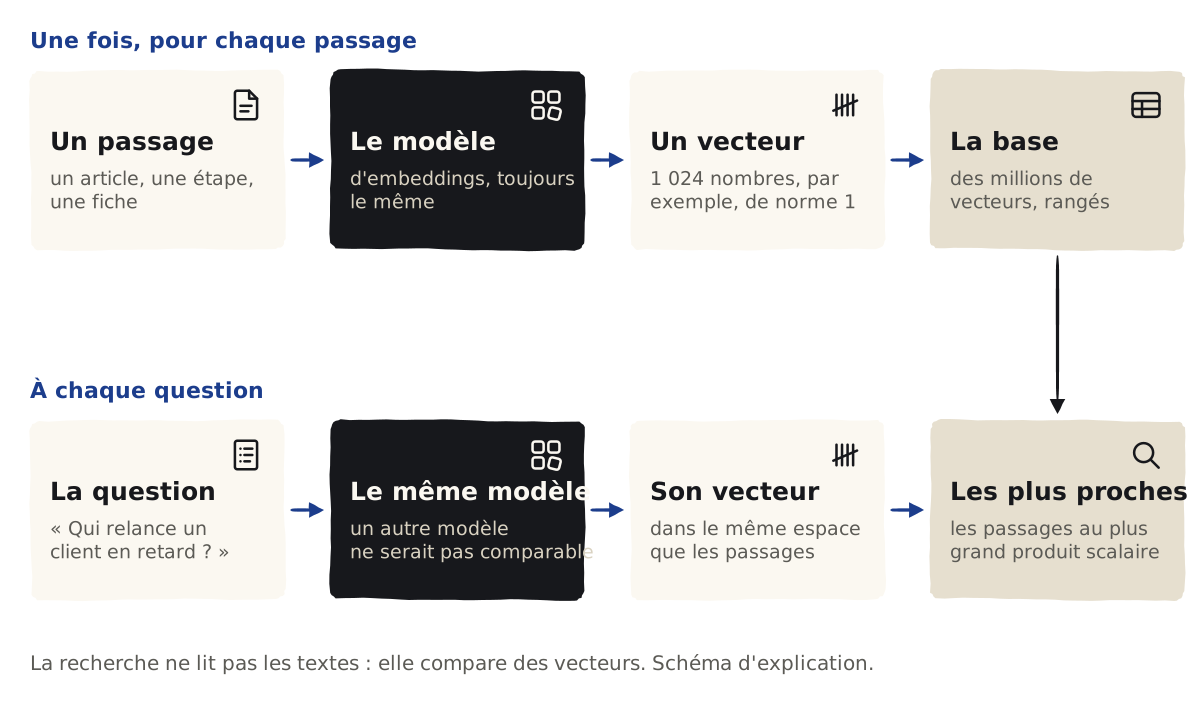
Indexer, une fois : chaque passage, découpé avant, devient un vecteur, rangé avec son texte et ses métadonnées. Un modèle ne lit qu'un texte limité d'un coup, 8 192 tokens chez OpenAI et Google : au-delà, il faut découper.
Chercher, à chaque question : la question devient un vecteur, par le même modèle, et la base rend les passages les plus proches. Sur quelques milliers de passages, une recherche exacte, qui compare tout, suffit ; sur des millions, les bases utilisent un index approché, comme HNSW, qui trouve presque toujours les mêmes passages, bien plus vite.
La place : un vecteur de 1 024 nombres, stocké en nombres de 4 octets, prend environ 4 Ko ; dans pgvector, 4 octets par dimension plus 8. Un million de passages à 3 072 dimensions occupent environ 12 Go.
Exemple détaillé
Neuf modèles d'embeddings, six par API et trois à installer chez soi, relevés le 7 octobre 2026. Le classement cité est MTEB, la référence publique des modèles d'embeddings.
Un avantageÀ savoirNon mesuré
Les bases vectorielles
Risques
| Ce qui guette | Pourquoi | La parade |
|---|---|---|
| Changer de modèle | Les vecteurs de deux modèles ne se comparent pas : Google le dit même entre ses deux versions | Tout réindexer ; garder le nom du modèle avec chaque vecteur. Exception : les modèles voyage-4 sont compatibles entre eux |
| Un passage trop long | Au-delà de ce que lit le modèle, le texte est refusé ou coupé | Découper avant, en passages qui gardent leur titre : une base de fiches |
| Plusieurs textes envoyés d'un bloc à Gemini | Ils reviennent en un seul vecteur, qui les mélange | Un objet par texte, ou l'API par lots |
| Se fier au classement d'un éditeur | Cohere annonce des scores en français mesurés sur ses propres tests | Lire MTEB, mesuré par un tiers, puis essayer sur vos textes |
| Oublier où partent les textes | Chaque passage indexé par une API part chez son éditeur | Un point d'accès européen, ou un modèle open weight installé chez vous |
Mise en place
- Le modèle : un modèle qui lit bien le français (le classement MTEB en français en donne un premier tri), au prix et à l'hébergement qui conviennent ; un modèle open weight si les textes ne doivent pas sortir.
- La base : pgvector si l'entreprise a déjà PostgreSQL ; Qdrant ou Chroma pour démarrer en local ; FAISS pour un essai en mémoire.
- Les métadonnées : avec chaque vecteur, le document, son titre, sa date, ses droits d'accès, et le nom du modèle qui l'a calculé.
- La mesure : vingt questions dont vous connaissez le passage attendu, essayées sur deux ou trois modèles avant de choisir : l'évaluation d'un outil d'IA.
- La suite : le découpage, les droits et la mise à jour d'un index qui sert tous les jours : un RAG en production.
Exercice
Une PME veut indexer 200 000 passages avec un modèle à 1 024 dimensions, dans pgvector. Quelle place prennent les vecteurs ? Et avec un modèle à 3 072 dimensions, que faut-il changer ?
Ouvrir la correction
La place200 000 × (4 × 1 024 + 8) octets, soit environ 821 Mo, sans compter le texte et l'index.
À 3 072 dimensionsTrois fois plus de place, environ 2,5 Go ; surtout, l'index HNSW de pgvector s'arrête à 2 000 dimensions : il faut réduire les dimensions, ce que permettent les modèles d'OpenAI et de Google, ou passer en demi-précision.
Vérification
1ComprendrePourquoi la question doit-elle passer par le même modèle que les passages ?
Parce que les vecteurs de deux modèles ne vivent pas dans le même espace : leurs distances ne veulent rien dire. Changer de modèle oblige à tout réindexer.
2AppliquerVos textes ne doivent pas quitter l'entreprise. Quel modèle d'embeddings prendre ?
Un modèle open weight installé sur vos machines, comme ceux du tableau : bien classés, gratuits, et rien ne part chez un éditeur.
3ComprendreQu'apporte une base vectorielle par rapport à une liste de vecteurs en mémoire ?
Elle range les vecteurs avec leur texte et leurs métadonnées, les garde d'un lancement à l'autre, et retrouve vite les plus proches parmi des millions, grâce à un index approché.
Lectures suivantes
Embeddings et bases vectorielles
Développement d'applications d'IA · étape 2 sur 10
Les pages qui renvoient ici
Limites et sources
Les modèles, les prix et les rangs du classement MTEB sont ceux du 7 octobre 2026 ; ils changent vite, et le classement se relit avant de choisir.
Les tailles en mémoire sont des calculs à partir de la documentation de pgvector, sans l'index ni le texte.
- Le tableau des modèles :
apprendre/donnees/embeddings.json, chaque case avec sa source. - Le relevé complet :
apprendre/recherches/2026-10-07-rag-technique.json.
Écrit par Meridal, avec l'aide de l'IA ; chaque fait vérifié à sa source et relu avant publication. Texte et schémas sous licence CC BY 4.0 : reprenez-les en citant Meridal. Le code sous licence MIT.
Un assistant qui connaît votre entreprise
3 300 € à 10 200 €, puis sur devis