Sur cette page
Répondez de tête, puis ouvrez. Tokens, fenêtre de contexte et prix
1Pourquoi une conversation coûte-t-elle de plus en plus cher à chaque échange ?
Parce que le modèle relit tout l'historique à chaque échange : ce qu'il lit grandit à chaque tour. Le cache réduit le prix de ce qui est relu.
2Deux modèles affichent le même prix par million de tokens. Coûtent-ils autant pour le même texte ?
Pas forcément : chaque éditeur découpe le texte à sa façon, et le même texte peut compter nettement plus de tokens chez l'un. Comparez sur vos textes, avec l'outil de comptage de chaque éditeur.
- Le streaming ne rend pas le modèle plus rapide : il montre la réponse pendant qu'elle s'écrit.
- Le cache fait relire à prix réduit le début d'une demande déjà vu : souvent 10 % du prix d'entrée, parfois 5 %.
- Le cache ne marche que si ce qui se répète est en tête : les consignes et les documents d'abord, la question à la fin.
- Les lots coûtent moitié prix chez OpenAI, Anthropic, Google et Mistral, contre un délai de quelques heures, jusqu'à 24.
- Chaque réponse de l'API dit combien de tokens ont été lus dans le cache : c'est là qu'on vérifie le gain.
Problème
Une application d'IA en service se juge sur deux choses : le temps qu'elle met à répondre, et ce qu'elle coûte chaque mois. Les deux dépendent moins du modèle choisi que de trois réglages que l'on oublie souvent : afficher la réponse au fil de l'eau, ne pas faire repayer ce qui se répète, et grouper ce qui n'est pas urgent.
Principe
- Le streaming : la réponse arrive morceau par morceau, au lieu d'arriver d'un bloc à la fin. Les quatre éditeurs l'offrent, par des événements envoyés par le serveur.
- Le cache : quand une demande commence comme une demande récente, l'éditeur relit ce début dans sa mémoire, à prix réduit. OpenAI annonce jusqu'à 95 % de remise sur l'entrée cachée.
- Les lots : on envoie un fichier de demandes, l'éditeur les traite quand il peut, à moitié prix.
Fonctionnement
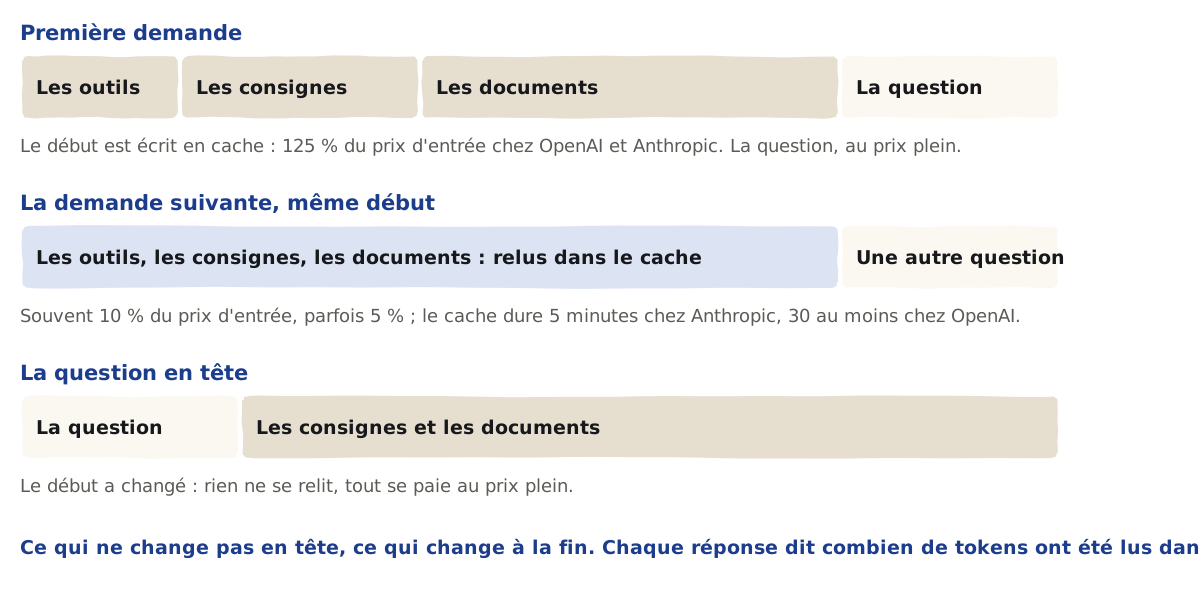
Le cache lit un préfixe : seul le début identique d'une demande se relit. Chez Anthropic, l'ordre compte : les outils, puis les consignes, puis les messages. D'où la règle : ce qui ne change pas en tête, ce qui change à la fin.
Il a une taille minimale : 1 024 tokens chez OpenAI, 512 chez Anthropic, 4 096 pour Gemini 3.x ; chez Anthropic, une demande plus courte passe sans cache, et sans erreur.
Il dure peu : cinq minutes chez Anthropic, prolongées à chaque usage ; au moins trente minutes chez OpenAI pour les modèles récents.
L'écriture coûte un peu plus : mettre en cache se paie 125 % du prix d'entrée chez OpenAI et chez Anthropic ; le gain vient dès la deuxième relecture.
Le streaming change le traitement des erreurs : une erreur peut arriver au milieu d'une réponse déjà commencée, et Anthropic exige le streaming pour les réponses très longues, sous peine d'expiration.
Exemple détaillé
Les règles du cache et des lots chez quatre éditeurs, relevées les 7 et 8 octobre 2026. Pour voir l'effet du cache sur une conversation, le calcul de la page des tokens le chiffre, avec et sans.
Un avantageÀ savoir
Risques
Mise en place
- Mettre en tête ce qui ne change pas : consignes, outils, documents de référence ; à la fin, la question.
- Lire les compteurs : chaque réponse dit combien de tokens ont été lus dans le cache ; chez Anthropic,
cache_read_input_tokens. - Streamer ce qu'une personne lit : une interface de discussion ; pas un traitement en arrière-plan.
- Passer par les lots ce qui peut attendre : un classement de courriels de la veille, une extraction de factures du mois, une évaluation.
- Suivre la facture : le coût d'un outil en service et le routage entre modèles.
Exercice
Un assistant reçoit 2 000 demandes par jour. Chacune commence par les mêmes consignes et la même charte, 6 000 tokens, puis une question de 200 tokens. Que faut-il changer pour que le cache serve, et sur quoi porte l'économie ?
Ouvrir la correction
L'ordreConsignes et charte en tête, sans date ni nom qui change ; la question à la fin. Le préfixe de 6 000 tokens dépasse les minimums de tous les éditeurs.
L'économieSur ces 6 000 tokens, à chaque demande servie depuis le cache : 90 % de leur prix d'entrée en moins chez la plupart, 95 % sur Claude Opus 5.5. Les 200 tokens de la question et les tokens écrits se paient au prix normal.
La conditionDes demandes assez rapprochées : cinq minutes chez Anthropic, prolongées à chaque usage ; avec 2 000 demandes par jour en journée, le cache reste chaud.
Vérification
1ComprendreLe streaming rend-il le modèle plus rapide ?
Non : la réponse met le même temps à s'écrire ; le streaming la montre pendant qu'elle s'écrit, ce qui change le temps avant le premier mot.
2AppliquerPourquoi placer la date du jour à la fin de la demande plutôt qu'au début ?
Parce que le cache ne relit que le début identique d'une demande : une date en tête change ce début chaque jour, et le cache ne sert plus.
3AppliquerQuelles tâches passer par les lots ?
Celles qui peuvent attendre quelques heures : traitements du soir, extractions mensuelles, évaluations. Elles coûtent alors moitié prix.
Lectures suivantes
Rien avant : c'est un point de départ.
Streaming, cache et traitement par lots
Les pages qui renvoient ici
Limites et sources
Les règles et remises sont celles des éditeurs aux 7 et 8 octobre 2026 ; elles changent avec les modèles.
La durée de vie du cache de Mistral n'est pas publiée dans les pages lues.
- OpenAI, Prompt caching ; Anthropic, Prompt caching ; Google, Context caching ; Mistral, Prompt caching.
- Les règles de la synthèse :
apprendre/donnees/cache-lots.json; le relevé :apprendre/recherches/2026-10-07-dev-appels-modeles.json.
Écrit par Meridal, avec l'aide de l'IA ; chaque fait vérifié à sa source et relu avant publication. Texte et schémas sous licence CC BY 4.0 : reprenez-les en citant Meridal. Le code sous licence MIT.
Garder vos outils en état
200 € à 1 500 € par mois