Sur cette page
- Chez OpenAI comme chez Anthropic, le prix d'entrée va de 0,10 $ à 10 $ le million de tokens : un rapport de 1 à 100, calculé sur leurs grilles.
- Router, c'est envoyer chaque demande au plus petit modèle qui la réussit : un classement à un petit modèle, une réponse délicate à un modèle plus fort.
- Trois façons : une règle fixe par type de demande ; une cascade, qui essaie le petit modèle et remonte s'il échoue ; un routeur tout fait, comme celui de Microsoft Foundry ou d'OpenRouter.
- Sur notre exemple, 70 % de demandes simples envoyées à un petit modèle font passer la facture de 149,60 $ à 51,04 $ par mois, tri compris.
- Ce qui « suffit » se mesure, sur vos cas : sans jeu de tests, le routage économise en silence sur la qualité.
Problème
Un outil d'IA reçoit des demandes très différentes : classer un courriel, extraire un montant, rédiger une réponse délicate, analyser un dossier de quatre-vingts pages. Avec un seul modèle pour tout, il faut choisir : un grand modèle, qui réussit tout mais fait payer le prix fort aux demandes faciles ; ou un petit, bon marché, qui échoue sur les difficiles.
L'écart n'est pas marginal. Chez OpenAI, GPT-6 Astra coûte 10 $ le million de tokens lus, GPT-6 Luna 0,10 $ ; chez Anthropic, de Claude Fable 5.1 à Claude Haiku 5.5, le même écart de 1 à 100. Le coût d'un outil en service se joue d'abord là : ce que coûte un outil d'IA en service.
Principe
Avant de regarder : sur cent demandes reçues par un service client, combien demandent vraiment le meilleur modèle ?
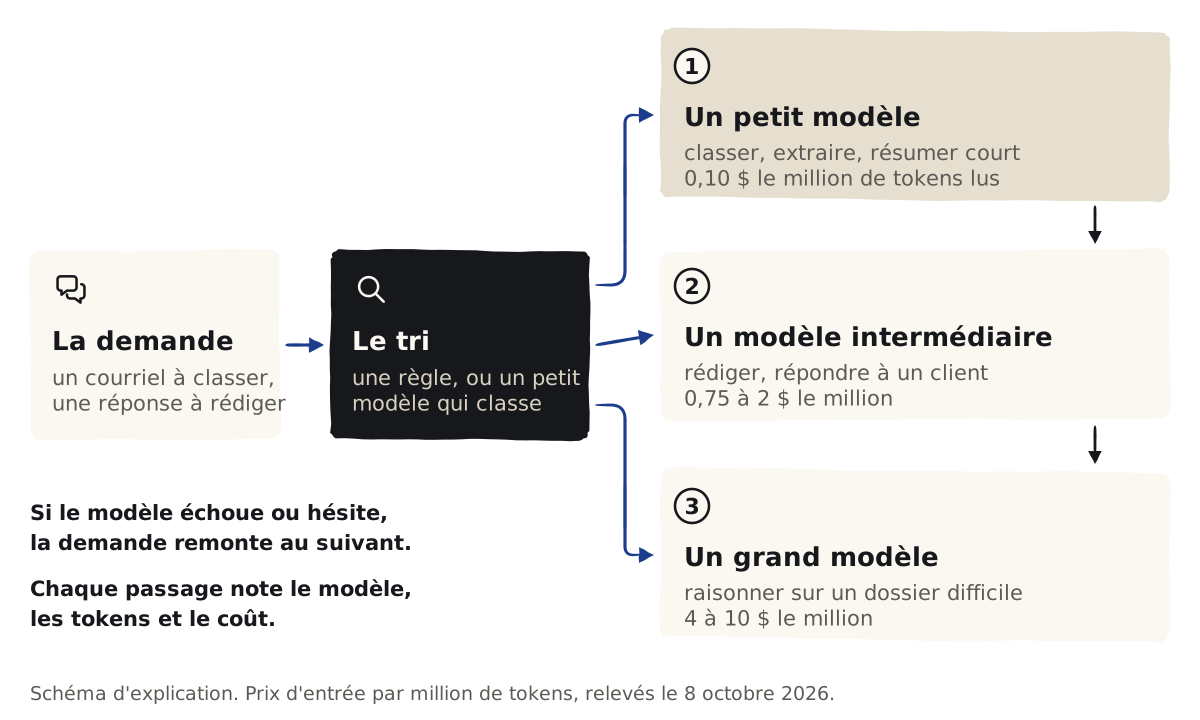
Souvent peu. Le principe du routage tient en une ligne : chaque demande va au plus petit modèle qui la réussit. Un tri décide, par une règle ou par un petit modèle qui classe ; ce qui échoue ou hésite remonte au modèle suivant ; et chaque passage laisse une trace, pour vérifier que l'économie ne se paie pas en erreurs.
Fonctionnement
Trois façons de router
- Une règle fixe le type de demande est connu d'avance : le formulaire, la boîte de réception, l'étape de l'automatisation le disent Ce qu'elle apporte : le plus simple, le plus prévisible, rien à payer pour le tri Sa limite : ne s'adapte pas à une demande inhabituelle
- Une cascade on essaie le petit modèle ; si sa réponse échoue à un contrôle, ou s'il dit ne pas savoir, la demande remonte au suivant Ce qu'elle apporte : le petit modèle traite tout ce qu'il sait faire Sa limite : le contrôle doit être fiable ; une demande remontée coûte deux appels
- Un routeur tout fait un service choisit le modèle à chaque demande : le model router de Microsoft Foundry, entraîné pour cela ; l'Auto Router d'OpenRouter Ce qu'elle apporte : rien à construire Sa limite : ses critères ne sont pas les vôtres ; il faut mesurer sur vos cas
Les outils qui routent
Le code, tel que les documentations le donnent, noms de modèles compris.
Plusieurs déploiements derrière un même nom de modèle ; la passerelle répartit les demandes et se replie en cas d'erreur.
Le routeur de LiteLLM, extrait de la documentationfrom litellm import Router
model_list = [{ # list of model deployments
"model_name": "gpt-5.6-luna", # model alias -> loadbalance between models with same `model_name`
"litellm_params": { # params for litellm completion/embedding call
"model": "azure/chatgpt-v-2", # actual model name
"api_key": os.getenv("AZURE_API_KEY"),
"api_version": os.getenv("AZURE_API_VERSION"),
"api_base": os.getenv("AZURE_API_BASE")
}
}, {
"model_name": "gpt-5.6-luna",
"litellm_params": { # params for litellm completion/embedding call
"model": "azure/chatgpt-functioncalling",
"api_key": os.getenv("AZURE_API_KEY"),
"api_version": os.getenv("AZURE_API_VERSION"),
"api_base": os.getenv("AZURE_API_BASE")
}
}, {
"model_name": "gpt-5.6-luna",
"litellm_params": { # params for litellm completion/embedding call
"model": "gpt-5.6-luna",
"api_key": os.getenv("OPENAI_API_KEY"),
}
}, {
"model_name": "gpt-5.6-terra",
"litellm_params": { # params for litellm completion/embedding call
"model": "azure/gpt-5.6-terra",
"api_key": os.getenv("AZURE_API_KEY"),
"api_base": os.getenv("AZURE_API_BASE"),
"api_version": os.getenv("AZURE_API_VERSION"),
}
}, {
"model_name": "gpt-5.6-terra",
"litellm_params": { # params for litellm completion/embedding call
"model": "gpt-5.6-terra",
"api_key": os.getenv("OPENAI_API_KEY"),
}
},
]
router = Router(model_list=model_list)
# openai.ChatCompletion.create replacement
# requests with model="gpt-5.6-luna" will pick a deployment where model_name="gpt-5.6-luna"
response = await router.acompletion(model="gpt-5.6-luna",
messages=[{"role": "user", "content": "Hey, how's it going?"}])
print(response)
# openai.ChatCompletion.create replacement
# requests with model="gpt-5.6-terra" will pick a deployment where model_name="gpt-5.6-terra"
response = await router.acompletion(model="gpt-5.6-terra",
messages=[{"role": "user", "content": "Hey, how's it going?"}])
print(response)pythonPas encore exécuté par Meridal. Ce code appelle des modèles payants ; la documentation de LiteLLM n'en montre pas la réponse.
Le modèle « openrouter/auto » laisse le routeur choisir ; la réponse dit lequel il a pris.
L'Auto Router d'OpenRouter, extrait de la documentationimport requests
import json
response = requests.post(
url="https://openrouter.ai/api/v1/chat/completions",
headers={
"Authorization": "Bearer <OPENROUTER_API_KEY>",
"Content-Type": "application/json",
},
data=json.dumps({
"model": "openrouter/auto",
"messages": [
{
"role": "user",
"content": "Explain quantum entanglement in simple terms"
}
]
})
)
data = response.json()
print(data['choices'][0]['message']['content'])
# Check which model was selected
print('Model used:', data['model'])pythonPas encore exécuté par Meridal. Ce code appelle un modèle payant ; il imprime la réponse, puis le nom du modèle que le routeur a choisi.
Exemple détaillé
Reprenons le service client de la page sur le coût : 400 demandes par jour ouvré, chacune lit 6 000 tokens et en écrit 500. Une partie des demandes sont de simples classements ; supposons, pour l'exemple, 70 % de demandes simples et 30 % de réponses à rédiger.
| Demande | Part | Modèle |
|---|---|---|
| Classer le courriel, extraire le numéro de commande | 70 % | Claude Haiku 5.5 |
| Rédiger la réponse au client | 30 % | Claude Sonnet 5.5 |
| Le tri lui-même, à chaque demande | 100 % | Claude Haiku 5.5, 1 000 tokens lus, 10 écrits |
Le même service client, trois façons de le servir
- Tout sur Claude Sonnet 5.5chaque demande au modèle intermédiaire149,60 $
- Routé70 % au petit modèle, 30 % à l'intermédiaire, tri compris51,04 $
- Tout sur Claude Haiku 5.5le moins cher, qui échouera sur les réponses délicates7,48 $
Le routage ramène la facture de 149,60 $ à 51,04 $ par mois, dont 0,92 $ pour le tri. Tout envoyer au petit modèle coûterait 7,48 $, mais les réponses délicates en pâtiraient. Ces chiffres ne valent que si le petit modèle réussit vraiment les classements : c'est ce que mesure l'évaluation d'un outil, cas par cas, avant de basculer.
Risques
- L'économie qui se paie en erreurs : un tri qui envoie une demande difficile au petit modèle donne une mauvaise réponse, moins chère. Sans jeu de tests, on ne le voit pas ; voir les jeux de tests.
- Des critères qui ne sont pas les vôtres : l'Auto Router d'OpenRouter classe les modèles selon les dépenses de la communauté, pas selon vos cas ; le routeur de Microsoft, en mode Balanced, accepte un modèle à 1 ou 2 % de la meilleure qualité, selon sa propre estimation.
- La fenêtre de contexte la plus petite : chez Microsoft, la fenêtre utile du routeur est celle du plus petit modèle sous-jacent ; un long document peut ne pas passer.
- Les frais d'un intermédiaire : OpenRouter ne majore pas le prix des modèles, mais prend 5,5 % sur l'achat de crédits, 8 % en offre Business ; avec vos propres clés, l'usage est gratuit jusqu'à 25 000 $ par mois, puis à 5 %.
- Le chemin des données : par OpenRouter, vos demandes passent par un intermédiaire de plus ; il ne garde par défaut que les métadonnées, et le routage dans l'Union européenne est réservé aux offres Business et Enterprise. Voir les données confiées à une IA.
- Le budget qui ne plafonne rien : chez LiteLLM, les budgets exigent une base de données ; sans elle, ils ne bloquent rien.
Mise en place
Lister les types de demandes et leurs volumes
Ce qu'on fait : classer, extraire, résumer, rédiger, analyser : combien de chaque, par jour.
Mesurer chaque type sur deux ou trois modèles
Ce qu'on fait : le même jeu de cas, un petit modèle, un intermédiaire, un grand ; on note les réussites et le coût (évaluer un outil d'IA).
Écrire la règle de tri la plus simple qui marche
Ce qu'on fait : une règle d'abord, quand le type est connu d'avance ; un petit modèle qui classe, seulement s'il le faut.
Prévoir l'escalade et le repli
Ce qu'on fait : ce qui échoue à un contrôle remonte au modèle suivant ; une panne chez un fournisseur bascule vers un autre, ce que fait une passerelle comme LiteLLM.
Noter le modèle choisi et le coût de chaque passage
Ce qu'on fait : dans les traces de l'outil (l'observabilité) ; et des budgets ou des plafonds chez chaque éditeur (le coût en service).
Refaire la mesure à chaque nouveau modèle
Ce qu'on fait : un nouveau petit modèle peut prendre des demandes au modèle intermédiaire ; un changement de prix peut renverser le calcul.
Exercice
Une entreprise de distribution veut router les demandes de ses outils d'IA. Pour chacune, choisissez un petit modèle, un intermédiaire ou un grand, et dites ce qu'il faudrait mesurer. L'entreprise et ses volumes sont fabriqués pour l'exercice.
- Classer les courriels entrants300 par jour
- Extraire le montant et la date des factures fournisseurs80 par jour
- Rédiger la réponse à une réclamation40 par jour
- Résumer un appel d'offres de quatre-vingts pages2 par semaine
- Traduire une fiche produit20 par jour
Voir la correction
Classer les courrielsUn petit modèle, entre des catégories fixes : c'est le plus gros volume, le gain est là. À mesurer : la part de courriels bien classés, et ce qui part en « autre ».
Extraire montant et dateUn petit modèle, suivi de règles qui vérifient le total et la date ; ce qui échoue au contrôle remonte au modèle suivant.
Répondre à une réclamationUn modèle intermédiaire, et une personne qui valide : l'enjeu est la relation client, pas le coût.
Résumer un appel d'offresUn grand modèle, ou un intermédiaire si la mesure le permet : deux par semaine, le coût compte peu ; vérifier aussi que le document tient dans la fenêtre de contexte.
Traduire une fiche produitÀ mesurer : un petit modèle peut suffire sur des fiches simples ; une personne relit les premières.
Vérification
1ComprendrePourquoi ne pas envoyer toutes les demandes au meilleur modèle ?
Parce que son prix peut être cent fois celui d'un petit modèle du même éditeur, alors que beaucoup de demandes, classer, extraire, n'en ont pas besoin.
2ComprendreQu'est-ce qu'une cascade ?
On essaie d'abord le petit modèle ; si sa réponse échoue à un contrôle, ou s'il dit ne pas savoir, la demande remonte au modèle suivant.
3AppliquerVous voulez confier les classements à un petit modèle. Que faire avant ?
Le mesurer sur le même jeu de cas que le modèle actuel, cas par cas ; garder une escalade pour ce qu'il rate ; suivre ensuite le coût et les erreurs dans les traces.
Lectures suivantes
Routage entre modèles et maîtrise du coût
Développement d'applications d'IA · étape 10 sur 10
Les pages qui renvoient ici
Limites et sources
Le partage 70 / 30 et l'exercice sont fabriqués ; les prix sont ceux du relevé du 8 octobre 2026.
Le code vient des documentations, sans avoir été exécuté ici ; les noms de modèles y sont ceux des éditeurs.
Le rapport de 1 à 100 est calculé sur les grilles de prix ; les éditeurs ne l'écrivent pas.
- Microsoft, model router ; OpenRouter, Auto Router ; OpenRouter, prix ; LiteLLM, routeur ; LiteLLM, budgets ; OpenAI, prix ; Anthropic, prix.
- Les relevés :
apprendre/recherches/2026-10-09-routage.jsonetapprendre/recherches/2026-10-08-dev-avance.json.
Écrit par Meridal, avec l'aide de l'IA ; chaque fait vérifié à sa source et relu avant publication. Texte et schémas sous licence CC BY 4.0 : reprenez-les en citant Meridal. Le code sous licence MIT.
Garder vos outils en état
200 € à 1 500 € par mois