Sur cette page
Répondez de tête, puis ouvrez. Embeddings et bases vectorielles
1Pourquoi la question doit-elle passer par le même modèle que les passages ?
Parce que les vecteurs de deux modèles ne vivent pas dans le même espace : leurs distances ne veulent rien dire. Changer de modèle oblige à tout réindexer.
2Qu'apporte une base vectorielle par rapport à une liste de vecteurs en mémoire ?
Elle range les vecteurs avec leur texte et leurs métadonnées, les garde d'un lancement à l'autre, et retrouve vite les plus proches parmi des millions, grâce à un index approché.
- La qualité d'un RAG tient d'abord aux documents : une version en vigueur, datée, tenue par quelqu'un.
- Chaque passage garde son contexte : le titre du document et de sa section, ou une phrase qui le situe.
- La recherche combine le sens et les mots exacts, puis un reclassement ; Anthropic mesure deux tiers d'échecs en moins avec les trois.
- Les droits se filtrent avant la recherche : un passage qu'une personne ne peut pas ouvrir ne doit jamais lui être servi.
- Chaque changement se mesure sur un jeu de questions dont on connaît le passage attendu, avant de partir en service.
Prérequis
- Le mécanisme de un RAG minimal, et le choix d'un modèle d'embeddings et d'une base.
- Des documents passés par la liste de contrôle : à jour, uniques, lisibles, bien partagés, tenus.
- Un jeu d'au moins vingt questions réelles, chacune avec le passage où se trouve la réponse.
Étapes
Préparer les documents
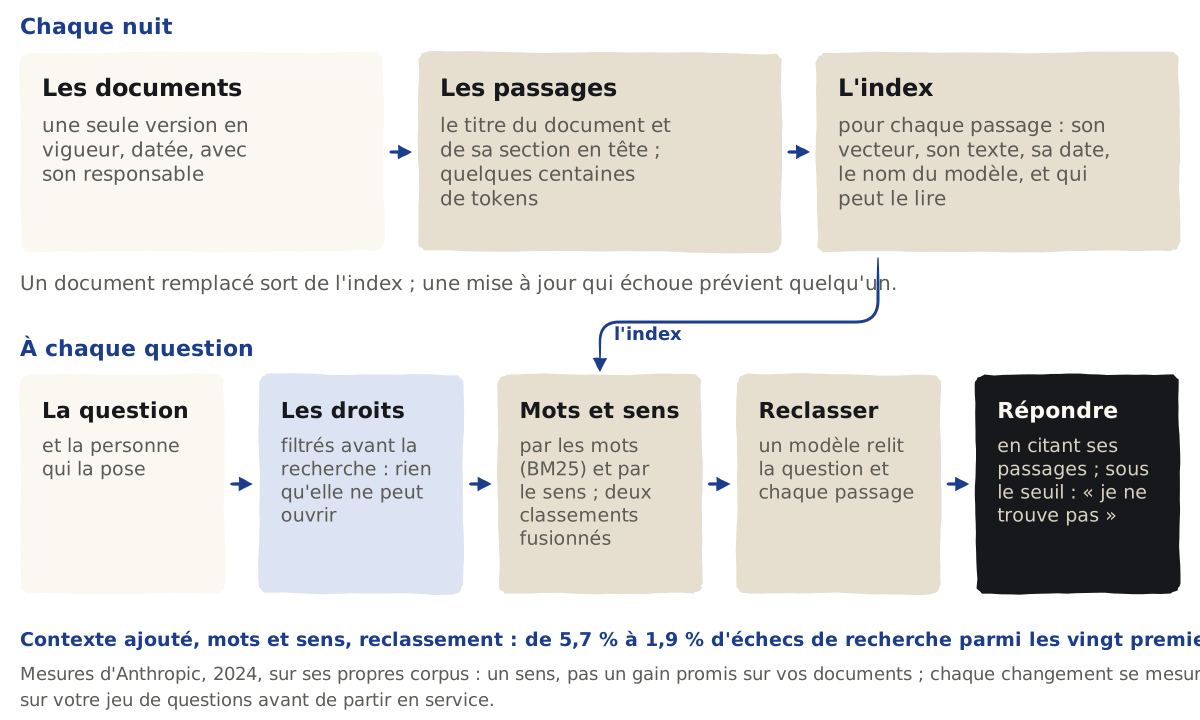
Une seule version en vigueur, des titres clairs, un résumé en tête, et des métadonnées : responsable, date d'effet, date de revue. Microsoft les conseille pour qu'un agent s'en tienne au contenu à jour. Le reste suit la base de fiches.Ce qu'on voit : chaque document avec son titre, sa date et son responsable, et plus aucune ancienne version dans ce que lira l'index.Découper en gardant le contexte
Un passage par section, de quelques centaines de tokens : OpenAI coupe par défaut à 800 tokens avec 400 de recouvrement, Mistral conseille d'essayer plusieurs tailles, les petits passages retrouvant souvent mieux. Chaque passage reçoit le titre de son document et de sa section ; Anthropic va plus loin et fait écrire par un modèle une phrase qui situe le passage, pour 50 à 100 tokens de plus par passage.Ce qu'on voit : des passages qui se comprennent lus seuls, avec leur titre en tête.Indexer, avec les droits
Chaque passage part avec son vecteur, son texte, le document, la date, le nom du modèle, et la liste des personnes ou des groupes qui peuvent le lire. Les métadonnées servent ensuite à filtrer avant la recherche, comme le conseille Mistral.Ce qu'on voit : un index où chaque passage porte ses droits d'accès.À vérifier : une personne qui perd l'accès à un dossier doit le perdre aussi dans l'index, à la mise à jour suivante.Chercher par le sens et par les mots
La recherche par le sens rate les termes exacts : un numéro de contrat, un nom de produit. La recherche hybride lance les deux, par les mots (BM25) et par les vecteurs, puis fusionne les deux classements. La recherche dans les fichiers d'OpenAI le fait déjà, avec un poids réglable entre les deux.Ce qu'on voit : les passages qui contiennent le terme exact remontent, même quand le sens est loin.Reclasser
Un modèle de reclassement relit la question et chaque passage trouvé, et les remet en ordre. Dans les mesures d'Anthropic, le contexte ajouté, la recherche hybride et le reclassement réduisent de 67 % les échecs de recherche parmi les vingt premiers passages, de 5,7 % à 1,9 %. Vingt passages donnés au modèle y faisaient mieux que dix ou cinq.Ce qu'on voit : une liste plus courte et mieux ordonnée de passages, prête pour la réponse.À vérifier : ces mesures datent de 2024 et portent sur les corpus d'Anthropic (code, fiction, articles scientifiques) : elles disent un sens, pas un gain sur vos documents.Répondre en citant, ou refuser
La réponse cite ses passages ; en dessous d'un seuil de proximité, aucun passage n'est donné, et l'assistant dit qu'il ne sait pas. OpenAI propose ce seuil dans sa recherche dans les fichiers.Ce qu'on voit : chaque réponse avec ses sources ; « je ne trouve pas » quand rien ne correspond.Tenir l'index à jour
Un document modifié se réindexe ; un document remplacé sort de l'index, sinon il trompe : dans une étude de 2025, un seul passage périmé fait baisser de plus de 24 % le score d'ensemble d'un grand modèle ouvert. La mise à jour tourne chaque nuit, et prévient quand elle échoue.Ce qu'on voit : une mise à jour datée chaque nuit, et un message quand elle n'a pas tourné.À vérifier : une mise à jour qui échoue en silence laisse l'index vieillir sans que personne le sache.Mesurer avant chaque changement
Sur le jeu de questions, la part des passages attendus retrouvés parmi les vingt premiers, puis la justesse des réponses. Ragas propose ces mesures (rappel du contexte, fidélité de la réponse) ; Anthropic conseille beaucoup de questions notées automatiquement plutôt que quelques-unes notées à la main.Ce qu'on voit : deux chiffres datés, à comparer avant et après chaque changement de modèle, de découpage ou de réglage.
Une base de savoir que l'assistant consulte avant de répondre
Des fiches reliées, servies à toute l'équipe par un connecteur hébergé en France ; les fiches confidentielles exclues avant toute réponse ; chaque nuit, une passe qui complète ce que l'équipe a signalé comme manquant. Sa limite rejoint l'étape 7 : les passes partaient d'un poste personnel et s'arrêtaient en silence.
Contrôle du résultat
Problèmes fréquents
Le bon passage n'est pas trouvé
CauseUn découpage qui coupe la règle de son titre, ou un terme exact que le sens ne voit pas.
À faireGarder le titre dans chaque passage ; ajouter la recherche par les mots ; reclasser.
La réponse cite une ancienne règle
CauseUne ancienne version est encore dans l'index.
À faireLa retirer ; ne garder que la version en vigueur, avec sa date.
Une personne lit un passage qu'elle ne devrait pas voir
CauseLes droits ne sont pas filtrés, ou pas mis à jour.
À faireFiltrer par les droits avant la recherche ; recalculer les droits à chaque mise à jour.
Le coût monte avec l'usage
CauseTrop de passages envoyés au modèle, ou un stockage hébergé facturé au jour.
À faireMoins de passages après reclassement ; chez OpenAI, le stockage se paie 0,10 $ par Go et par jour au-delà du premier Go.
Les tableaux répondent mal
CauseUn tableau découpé perd ses en-têtes.
À faireRépéter les en-têtes dans chaque passage, ou écrire le tableau en phrases.
Retour en arrière
- Garder deux index : le nouveau se construit à côté de l'ancien, et ne le remplace qu'après une mesure meilleure sur le jeu de questions.
- Garder le nom du modèle avec chaque vecteur : revenir à l'ancien modèle n'est possible qu'avec l'ancien index.
Variantes par outil
La recherche dans les fichiers d'OpenAI fait le découpage (800 tokens, 400 de recouvrement par défaut, réglables de 100 à 4 096), la recherche hybride et le seuil ; chaque fichier peut porter des attributs pour filtrer. Stockage : 0,10 $ par Go et par jour au-delà du premier Go ; 2,50 $ les mille recherches.
La recherche dans les fichiers de l'API Gemini stocke et calcule les vecteurs de la question gratuitement ; l'indexation se paie au prix des embeddings. Jusqu'à 100 Mo par document ; Google conseille de rester sous 20 Go par magasin.
Un agent SharePoint ne montre que le contenu que la personne peut ouvrir : les droits viennent de SharePoint, sans les recopier. Les limites et les droits : Copilot Studio.
Vérification
1ComprendrePourquoi combiner la recherche par le sens et par les mots ?
Parce que le sens rate les termes exacts, comme un numéro de contrat, et que les mots ratent les reformulations ; ensemble, puis reclassés, ils retrouvent plus souvent le bon passage.
2AppliquerOù se filtrent les droits d'accès dans un RAG ?
Avant la recherche, sur les métadonnées de chaque passage : un passage qu'une personne ne peut pas ouvrir ne doit jamais lui être servi.
3AppliquerVous changez de modèle d'embeddings. Que faire avant de basculer ?
Construire un nouvel index à côté de l'ancien, le mesurer sur le jeu de questions, et ne basculer que si la mesure est meilleure.
Lectures suivantes
Rien avant : c'est un point de départ.
Un RAG en production
Développement d'applications d'IA · étape 3 sur 10
Les pages qui renvoient ici
Limites et sources
Les gains cités viennent des mesures publiées par Anthropic en 2024 et d'une étude de 2025, sur leurs corpus : sur vos documents, seule votre mesure tranche.
Les prix et limites des solutions hébergées sont ceux du 7 octobre 2026.
- Anthropic, Introducing Contextual Retrieval ; OpenAI, Retrieval ; Google, File search ; Ragas, metrics.
- Les relevés :
apprendre/recherches/2026-10-07-rag-technique.jsonet…-preparer-documents.json.
Écrit par Meridal, avec l'aide de l'IA ; chaque fait vérifié à sa source et relu avant publication. Texte et schémas sous licence CC BY 4.0 : reprenez-les en citant Meridal. Le code sous licence MIT.
Un assistant qui connaît votre entreprise
3 300 € à 10 200 €, puis sur devis