Sur cette page
Répondez de tête, puis ouvrez. Comment se fabrique un modèle
1Quelles sont les deux grandes étapes de la fabrication d'un modèle, et laquelle coûte le plus de calcul ?
Le pré-entraînement, où il apprend à prédire le texte, et le post-entraînement, où il apprend à répondre. Le premier prend presque tout le calcul.
2Pourquoi un modèle plus petit peut-il donner de meilleures réponses qu'un plus gros ?
Parce que le post-entraînement, bref mais décisif, lui apprend à répondre ; en 2022, un modèle plus de cent fois plus petit, ainsi ajusté, était préféré.
- Ajuster, c'est prolonger le post-entraînement d'un modèle sur vos exemples : il apprend une façon de répondre, un format, une tâche répétée.
- Il apprend mal des faits nouveaux : pour vos documents, le RAG fait mieux dans les études publiées.
- L'offre se resserre : OpenAI ferme la sienne aux nouveaux travaux le 6 janvier 2027, Mistral a déprécié la sienne, Anthropic n'en a pas dans son API.
- L'entraînement coûte peu, de 1 $ à 60 $ pour 500 exemples ; l'hébergement peut coûter bien plus, 1,70 $ par heure chez Microsoft.
- OpenAI, Google et Microsoft disent la même chose : mesurer et soigner la demande d'abord, ajuster seulement si cela ne suffit pas.
Problème
Une PME veut que son assistant range chaque demande de client dans l'une de ses douze catégories, avec son vocabulaire à elle, au même format à chaque fois. Les consignes sont longues, les exemples aussi, et le résultat varie encore. Elle entend parler d'ajustement : « entraîner le modèle sur nos données ». Elle pense lui apprendre son catalogue et ses procédures. Ce n'est pas ce que fait un ajustement, et ce n'est souvent pas ce dont elle a besoin.
Principe
Ajuster, en anglais fine-tuning, c'est poursuivre l'entraînement d'un modèle déjà fabriqué sur vos propres exemples : une demande, et la réponse que vous attendez. Le modèle apprend à reproduire ces réponses.
Ce qu'il apprend bien : un format, un ton, une classification, une tâche trop difficile à décrire dans une demande, ou une demande plus courte pour le même résultat, donc moins de tokens. OpenAI cite aussi l'entraînement sur plus d'exemples qu'une demande n'en contient, et la possibilité de passer à un modèle plus petit et moins cher.
Ce qu'il apprend mal : des faits. Les exemples qui apportent une connaissance nouvelle s'apprennent plus lentement, et une fois appris ils augmentent la tendance du modèle à inventer. Sur des tâches de connaissances, le RAG fait mieux que l'ajustement, pour des faits déjà vus comme pour des faits nouveaux.
Fonctionnement
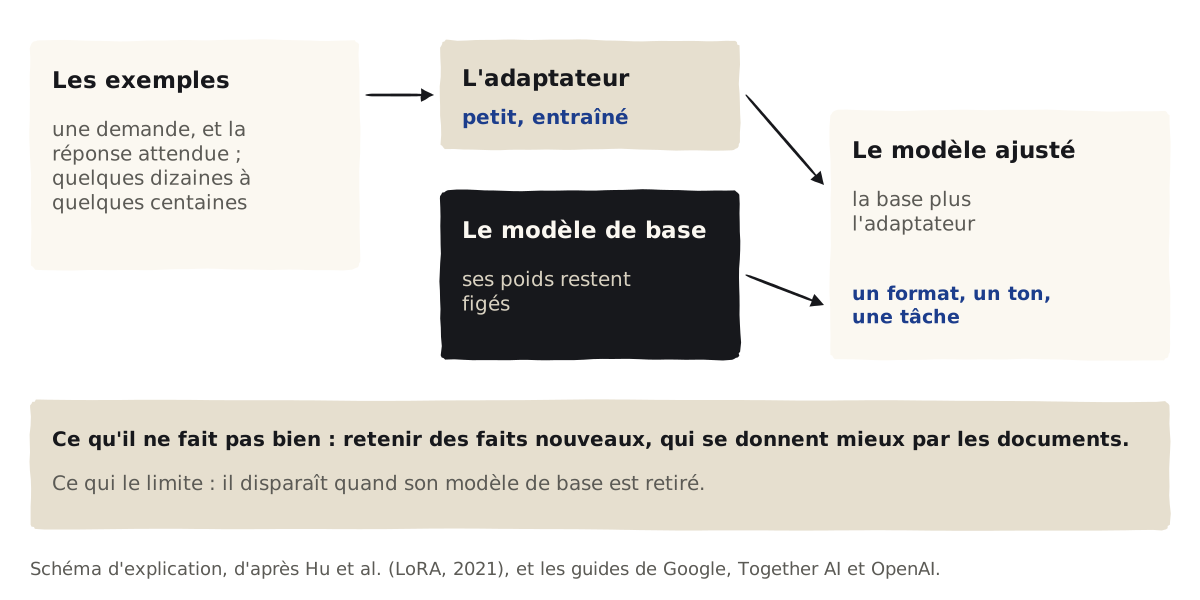
- Les exemples, dans un fichier JSONL, une ligne par exemple. OpenAI demande 10 exemples au minimum et conseille d'en commencer avec 50 bien écrits ; Microsoft parle de 50 à 100 pour un essai, 500 et plus en production.
- La méthode. La plus courante : un adaptateur, LoRA, qui laisse les poids du modèle figés et n'entraîne que de petites matrices ajoutées ; sur GPT-3, ses auteurs divisaient par 10 000 les paramètres à entraîner. Le réglage complet, qui modifie tous les poids, coûte plus à entraîner et à servir.
- Les passages : le fichier est lu plusieurs fois, les époques ; on paie les tokens du fichier multipliés par le nombre de passages.
- La validation : une partie des exemples, gardée de côté, dit si le modèle progresse ou s'il apprend par cœur.
- Le déploiement : le modèle ajusté est servi par l'offre, au prix du modèle de base ou plus cher, parfois avec un hébergement à l'heure.
Deux variantes : l'ajustement par préférences, DPO, apprend à préférer une réponse à une autre, sans modèle de récompense séparé ; l'ajustement par renforcement, RFT, note les réponses du modèle par un programme, et sert aux tâches dont la bonne réponse se vérifie.
Exemple détaillé
Le prix d'un même entraînement, offre par offre
Voir en tableau
| Offre | Modèle | Entraînement | Ensuite |
|---|---|---|---|
| OpenAI | gpt-4.1 | 50 $ | clients existants seulement |
| OpenAI | gpt-4.1-mini | 10 $ | clients existants seulement |
| Microsoft Foundry | gpt-4.1, Sweden Central | 60,50 $ | puis 1,70 $ par heure d'hébergement |
| Microsoft Foundry | gpt-4.1, Global | 50 $ | puis 1,70 $ par heure d'hébergement |
| Gemini 2.5 Pro | 50 $ | modèle retiré le 20 octobre 2026 | |
| Gemini 3.5 Flash | 20 $ | usage au prix de base fois 1,5 | |
| Gemini 3.1 Flash-Lite | 6 $ | usage au prix de base fois 1,5 | |
| Amazon Bedrock | Nova Pro | 16 $ | puis 1,95 $ par mois de stockage |
| Amazon Bedrock | Llama 3.3 70B | 6,60 $ | puis 1,95 $ par mois de stockage |
| Together AI | Llama 3.3 70B | 4,06 $ | serveur dédié en plus |
| Fireworks AI | modèle de 16 à 80 milliards | 6 $ | LoRA ; usage au prix de base |
| Fireworks AI | modèle jusqu'à 16 milliards | 1 $ | LoRA ; usage au prix de base |
Dans ce scénario, l'entraînement pèse peu. Ce qui pèse : l'hébergement, le prix de chaque appel au modèle ajusté, et le travail des exemples, qu'on écrit et qu'on relit à la main.
Risques
Mise en place
- Mesurer d'abord : un jeu de questions avec les réponses attendues, avant tout ajustement ; OpenAI le demande en premier. La méthode : évaluation d'un outil d'IA.
- Soigner la demande, avec des exemples dedans : Google, Mistral et OpenAI disent de commencer par là. Anthropic conseille de mettre une base de moins de 200 000 tokens, environ 500 pages, directement dans la demande.
- Donner les faits par les documents : le RAG.
- Ajuster seulement si la forme reste instable, sur 50 exemples d'abord. Si 50 exemples ne changent rien, OpenAI conseille de revoir la tâche ou la demande avant d'en ajouter.
- Envisager la distillation : régler la demande sur un grand modèle, puis ajuster un plus petit sur ses réponses, pour un coût d'usage plus bas.
- Choisir l'offre d'après sa date de fermeture, la région d'entraînement et l'hébergement, pas le prix de l'entraînement.
Exercice
Vous avez 300 exemples d'environ 1 500 tokens chacun, à passer trois fois. Combien de tokens sont facturés ? Que coûte l'entraînement sur Gemini 3.1 Flash-Lite, à 0,003 $ le millier de tokens, et chez Together AI sur Llama 3.1 8B, à 0,34 $ le million avec un minimum de 4 $ par travail ?
Ouvrir la correction
Les tokens300 × 1 500 = 450 000 tokens dans le fichier ; trois passages : 1 350 000 tokens facturés.
Google1 350 milliers × 0,003 $ = 4,05 $.
Together AI1,35 million × 0,34 $ = 0,46 $, sous le minimum : le travail coûte 4 $.
Ce qu'il faut retenirLes deux entraînements coûtent à peu près le même prix ; la différence se fera sur l'usage, au prix de base fois 1,5 chez Google pour Gemini 3, et sur un serveur dédié payé à la minute chez Together AI.
Vérification
1ComprendreUn ajustement sur vos procédures internes suffit-il pour que l'assistant les connaisse ?
Non. L'ajustement apprend une façon de répondre, pas des faits ; apprendre des faits nouveaux par ce biais augmente même les inventions. Les procédures se donnent par les documents, avec un RAG.
2AppliquerVotre entraînement a coûté 50 $. Quel autre coût vérifier avant de lancer le projet ?
L'hébergement et l'usage du modèle ajusté : chez Microsoft, 1,70 $ par heure, soit 1 224 $ par mois de 720 heures, avant le moindre appel.
3ComprendrePourquoi un modèle ajusté peut-il cesser de fonctionner sans que vous ayez rien changé ?
Parce qu'il disparaît avec son modèle de base : quand l'éditeur retire la base, il faut réentraîner sur une autre.
Lectures suivantes
Rien avant : c'est un point de départ.
Ajustement d'un modèle
Les pages qui renvoient ici
Limites et sources
Le graphique et l'exercice sont des calculs sur les prix publiés le 9 octobre 2026 ; ils ne comptent ni la validation, ni l'hébergement, ni l'usage, dits à part.
Les gains annoncés par les éditeurs, comme les 81,5 % à 99,6 % de bonnes classifications d'Anthropic en 2024 ou le « jusqu'à 66 % » d'AWS, sont des mesures d'éditeur.
Les offres ferment vite ; la page dit leur état au 9 octobre 2026.
- OpenAI, Deprecations ; OpenAI, Supervised fine-tuning ; Google, prix de l'ajustement ; Microsoft Foundry, fine-tuning ; Azure, prix.
- Hu et al., LoRA ; Ovadia et al., RAG ou ajustement ; Gekhman et al. ; Qi et al..
- Le relevé :
apprendre/recherches/2026-10-09-fine-tuning.json, 59 sources, 126 faits, 8 offres.
Écrit par Meridal, avec l'aide de l'IA ; chaque fait vérifié à sa source et relu avant publication. Texte et schémas sous licence CC BY 4.0 : reprenez-les en citant Meridal. Le code sous licence MIT.
Un assistant qui connaît votre entreprise
3 300 € à 10 200 €, puis sur devis