Sur cette page
Répondez de tête, puis ouvrez. Le RAG : une IA qui répond avec les documents de l'entreprise
1Un RAG garantit-il qu'une réponse est juste ?
Non. Il la rend vérifiable, parce qu'elle cite ses passages. Si un document est faux ou périmé, la réponse le sera aussi.
2Qu'est-ce qui compte le plus pour la qualité des réponses ?
L'état des documents : à jour, sans doublons ni versions qui se contredisent, lisibles par une machine.
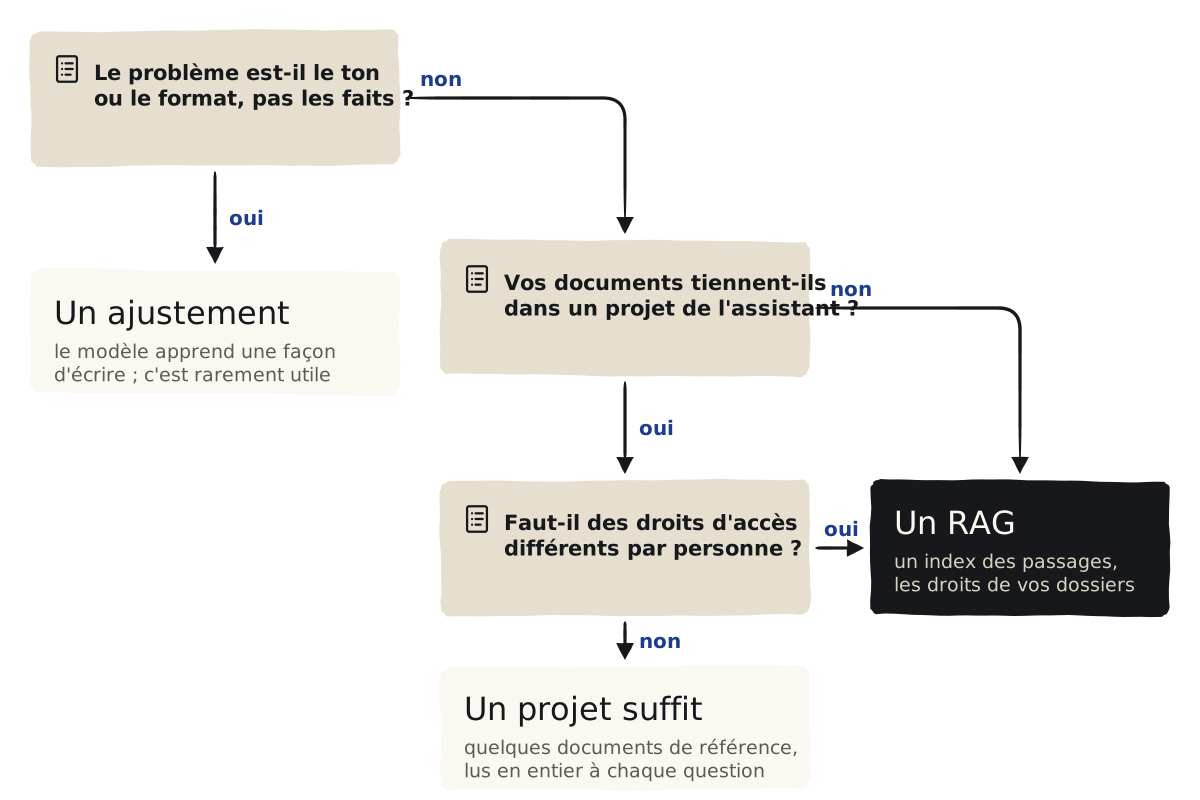
- Pour quelques dizaines de documents, un projet dans votre assistant suffit : le modèle les lit tous à chaque question.
- Au-delà, ou quand chacun ne doit voir que ses documents, un RAG cherche les bons passages avant de répondre.
- Réentraîner un modèle sur vos documents n'est presque jamais la bonne réponse : il faudrait recommencer à chaque changement.
- OpenAI ferme son service d'ajustement aux nouveaux clients, et à tous le 6 janvier 2027 ; Mistral a abandonné le sien.
- Dans les trois cas, la qualité tient d'abord à l'état de vos documents.
Options
Avant de lire l'arbre : pour vingt procédures de quelques pages, quelle façon prendriez-vous ?
- Un projet contexte long
- Vous déposez les documents dans un projet de votre assistant ; à chaque question, le modèle les relit tous. Les modèles actuels lisent jusqu'à environ un million de tokens d'un coup, soit quelque 2 500 pages au compte d'Anthropic, qui donne 500 pages pour 200 000 tokens.
- Un RAG retrieval-augmented generation
- Une recherche choisit d'abord les passages utiles, puis le modèle répond à partir d'eux, en les citant. C'est le mécanisme de la page du RAG.
- Un ajustement fine-tuning
- Le modèle est réentraîné sur des exemples de questions et de réponses. Il apprend une façon de répondre, pas une base de documents qu'on pourrait mettre à jour.
Sélection par besoin
| Votre situation | La façon qui convient |
|---|---|
| Quelques dizaines de documents, lus par toute l'équipe | Un projet, ou un bloc-notes, dans l'assistant que vous avez |
| Des documents qui changent chaque semaine | Un projet qui suit vos fichiers (Copilot Notebooks, Gemini Notebook), ou un RAG |
| Des centaines de documents, ou plus | Un RAG |
| Chacun ne doit voir que ce qu'il a le droit de lire | Un RAG qui filtre selon la personne, ou un agent qui respecte les droits de SharePoint |
| Du confidentiel à tenir à part | Un RAG, avec ces documents exclus ou réservés |
| Un ton ou un format précis, sur des milliers de textes | D'abord des consignes et des exemples dans la demande ; un ajustement seulement ensuite, sur un modèle qui le permet encore |
Comparatif
Les trois façons, sur cinq questions. Relevé le 7 octobre 2026 sur les pages des éditeurs ; la source est au bout de chaque case.
Un avantageÀ savoir
Méthode
Ce comparatif s'appuie sur la documentation des éditeurs : les fenêtres de contexte et les prix d'Anthropic, d'OpenAI et de Google, leurs avertissements sur les longs contextes, la page de dépréciations d'OpenAI et celle de Mistral sur l'ajustement, lues le 7 octobre 2026. Les deux annonces sur l'ajustement ont été relues à la source le même jour. Aucun test de Meridal n'y est mêlé.
En 2024, Anthropic conseillait de tout mettre dans la demande sous 200 000 tokens, environ 500 pages, et de passer à un RAG au-delà. Les fenêtres ont grandi depuis ; le seuil pratique dépend surtout de ce que coûte la relecture de tout à chaque question, et de la baisse de précision sur de longs contextes.
Pièges de lecture
- Un million de tokens ne veut pas dire tout lu avec la même attention. Anthropic écrit que la précision baisse quand le contexte s'allonge ; Google, que trouver plusieurs faits dans un long texte est plus difficile qu'en trouver un.
- Un long contexte se paie à chaque question. Tout est relu à chaque fois ; la mise en cache réduit ce coût, et chez OpenAI, au-delà de 272 000 tokens, l'entrée de GPT-6 Astra coûte deux fois plus.
- Un RAG ne rend pas une réponse juste. Il la rend vérifiable : si la recherche ne trouve pas le bon passage, la réponse se trompe aussi.
- L'ajustement n'est pas une base de documents. OpenAI le présente pour donner plus d'exemples, raccourcir les demandes, entraîner sur des données sensibles ou passer à un modèle plus petit ; il vient après des évaluations, et il ferme.
Vérification
1AppliquerVotre équipe a dix procédures de quelques pages. Faut-il un RAG sur mesure ?
Probablement pas : un projet ou un bloc-notes dans l'assistant que vous avez suffit.
2ComprendreQuand un RAG sur mesure se justifie-t-il ?
Avec beaucoup de documents, des droits d'accès différents selon les personnes, ou du confidentiel à tenir à part.
3ComprendrePourquoi ne pas réentraîner un modèle sur vos tarifs ?
Parce qu'il faudrait le réentraîner à chaque changement de tarif, que le modèle ajusté répondrait de la même façon à tous, et qu'OpenAI et Mistral ferment ce service.
Lectures suivantes
Rien avant : c'est un point de départ.
Projet, RAG ou ajustement du modèle
L'IA sur vos documents · étape 3 sur 8
Limites et sources
Cette page aide à choisir ; elle ne remplace pas un essai sur vos documents, avec cinq questions dont vous connaissez la réponse.
Les fenêtres de contexte et les prix changent vite : ils sont relevés le 7 octobre 2026, avec leur source au bout de chaque case.
- OpenAI, Deprecations : la fin de l'ajustement en libre-service ; Model optimization.
- Mistral, Fine-tuning, marqué abandonné.
- Anthropic, Context windows et Prompt caching ; Introducing Contextual Retrieval, 19 septembre 2024.
- Google, Long context ; OpenAI, GPT-6 Astra.
Écrit par Meridal, avec l'aide de l'IA ; chaque fait vérifié à sa source et relu avant publication. Texte et schémas sous licence CC BY 4.0 : reprenez-les en citant Meridal. Le code sous licence MIT.
Un assistant qui connaît votre entreprise
3 300 € à 10 200 €, puis sur devis