Sur cette page
Répondez de tête, puis ouvrez. Écrire une demande à une IA
1Quelles sont les cinq parties d'une bonne demande ?
Le contexte, la tâche, un exemple, le format, les critères. Seule la tâche est indispensable ; les autres rendent la réponse utilisable du premier coup.
2Vous joignez un rapport de trente pages et posez une question. Où placer la question ?
À la fin, après le document ; et demander de citer les passages sur lesquels la réponse s'appuie.
- Écrivez d'abord ce qu'est une bonne réponse : Anthropic fait de critères précis et mesurables le préalable de tout travail sur une demande, OpenAI demande de dire ce qui compte comme terminé.
- Les exemples montrent surtout le format et le genre de réponse ; sur un modèle qui raisonne, essayez d'abord sans : ils dégradent DeepSeek-R1.
- Un rôle règle le ton, pas la justesse : 162 rôles testés n'ont pas rendu les réponses plus justes, et un rôle hors sujet a fait refuser Gemini 2.5 Flash en moyenne 10,6 fois sur 25.
- « Réfléchis étape par étape » rapportait 30 points en 2022 ; sur les modèles de 2025, quelques points au mieux, parfois moins, pour des réponses plus lentes.
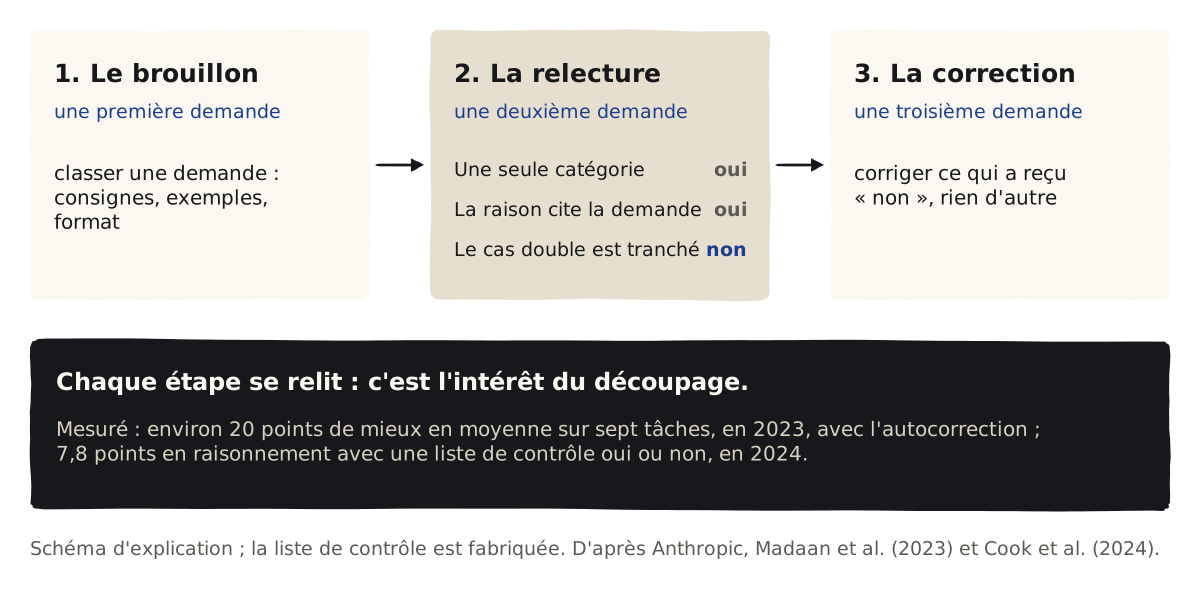
- Découper la tâche, brouillon, relecture par une liste de contrôle, correction, permet de relire chaque étape ; l'autocorrection a fait gagner environ 20 points en 2023.
Prérequis
- Une demande de base qui marche déjà en partie (écrire une demande).
- Cinq à dix cas réels de la tâche, avec la réponse attendue : ils serviront à tester chaque version de la demande (évaluer un outil d'IA).
- Savoir si votre modèle raisonne avant de répondre : plusieurs techniques changent de sens selon la réponse (les modèles qui raisonnent).
Étapes
Écrire les critères avant la demande
Ce qu'on écrit : trois à cinq critères vérifiables : « une seule catégorie », « la raison cite la demande », « moins de 120 mots ».
Le conseil : précis, mesurables, utiles : Anthropic les demande avant tout travail sur une demande ; OpenAI ajoute de dire quelles décisions le modèle peut prendre seul, et quand il doit demander.
Séparer les parties par des balises
Ce qu'on écrit : <contexte>, <consignes>, <exemples>, <demande> : chaque partie entre ses balises.
Le conseil : Anthropic les recommande pour éviter les confusions ; pour de nombreux documents, OpenAI a trouvé le XML efficace et le JSON particulièrement mauvais.
Choisir deux ou trois exemples variés
Ce qu'on écrit : des cas différents, au même format, chacun entre balises <exemple>.
Le conseil : ils montrent surtout le format et le genre de réponse : des étiquettes tirées au hasard dans les exemples ont à peine changé le résultat ; trop d'exemples font copier, prévient Google. Sur un modèle qui raisonne, essayer d'abord sans, comme le conseille OpenAI.
Un rôle pour le ton, s'il le faut
Ce qu'on écrit : « Vous êtes le responsable administratif d'une PME… » quand le ton ou le point de vue comptent.
Le conseil : Anthropic et Mistral le conseillent pour le ton et le comportement ; pour la justesse, aucune étude lue ne trouve de gain fiable.
Laisser le modèle raisonner
Ce qu'on écrit : sur un modèle qui raisonne, régler l'effort de réflexion plutôt qu'écrire « réfléchis étape par étape ».
Le conseil : Anthropic préfère une consigne générale comme « réfléchis soigneusement » à un plan écrit à la main ; ses modèles les plus récents peuvent refuser d'écrire leur raisonnement.
Découper la tâche en étapes
Ce qu'on écrit : une demande pour le brouillon, une pour la relecture, une pour la correction.
Le conseil : chaque étape se relit : c'est le découpage le plus courant selon Anthropic ; Google propose aussi des chaînes et des demandes en parallèle.
Faire relire par une liste de contrôle
Ce qu'on écrit : les critères de l'étape 1, transformés en questions à répondre par oui ou non.
Le conseil : une liste oui ou non a fait gagner 7,8 points en raisonnement ; sur Claude Opus 5, Anthropic conseille au contraire de retirer les consignes de vérification héritées, qui font trop vérifier.
Alléger
Ce qu'on écrit : chaque consigne une fois, sans majuscules ni « IMPÉRATIF », et le ton décrit par des choix concrets plutôt que par « chaleureux ».
Le conseil : OpenAI a gagné 10 à 15 % sur ses tests internes en retirant les consignes et les exemples répétés ; Anthropic note que les consignes criées font trop réagir ses modèles.
Les deux demandes, prêtes à copier. Une PME qui trie les messages de son formulaire ; l'entreprise et les messages sont fabriqués pour l'exemple. La première porte les critères, les balises et trois exemples variés ; la seconde est la liste de contrôle de la relecture, tirée des mêmes critères.
Le brouillon : la demande de classement<contexte> Nous sommes une PME qui vend et entretient des chaudières. Les demandes arrivent par le formulaire du site ; chacune doit partir vers le bon service. </contexte> <consignes> Classe la demande dans une seule catégorie : Dépannage, Entretien, Devis, Facturation, Autre. Réponds sur deux lignes : Catégorie : … Raison : une phrase qui cite les mots de la demande. Si la demande relève de deux catégories, choisis celle qui demande une intervention, et dis-le dans la raison. </consignes> <exemples> <exemple> Demande : « Plus d'eau chaude depuis ce matin, la chaudière affiche F28. » Catégorie : Dépannage Raison : « plus d'eau chaude » et un code d'erreur signalent une panne. </exemple> <exemple> Demande : « Je ne comprends pas la ligne "forfait déplacement" sur ma dernière facture. » Catégorie : Facturation Raison : la question porte sur « ma dernière facture ». </exemple> <exemple> Demande : « Combien coûterait le remplacement de ma vieille chaudière au fioul ? » Catégorie : Devis Raison : « combien coûterait » demande un prix avant travaux. </exemple> </exemples> <demande> [Collez ici la demande du client] </demande>
La relecture : la liste de contrôleVoici une demande de client et la classification proposée. Réponds par oui ou par non à chaque question : 1. Une seule catégorie est donnée, parmi les cinq ? 2. La raison cite des mots de la demande ? 3. Si deux catégories étaient possibles, celle qui demande une intervention a été choisie ? [Collez ici la demande et la classification]
Contrôle du résultat
Problèmes fréquents
Les réponses recopient les exemples
CauseTrop d'exemples, ou trop semblables.
À faireDeux ou trois exemples, différents entre eux ; Google prévient du risque.
Le modèle refuse, en disant qu'il n'est pas expert
CauseUn rôle sans rapport avec la question.
À faireRetirer le rôle, ou le prendre dans le domaine de la tâche.
Une consigne appliquée partout, même à tort
CauseUne consigne écrite en majuscules, ou répétée.
Ce que rapporte « réfléchis étape par étape », d'une génération à l'autre
Voir en tableau
| Année | Modèle | Points |
|---|---|---|
| 2022 | text-davinci-002 | +30,3 |
| 2025 | GPT-4o | +6,9 |
| 2025 | Gemini 2.0 Flash | +6,2 |
| 2025 | GPT-4o-mini | +0,4 |
| 2025 | Claude Sonnet 3.5 | −1,9 |
| 2025 | o4-mini | +3,1 |
| 2025 | o3-mini | +2,9 |
| 2025 | Gemini 2.5 Flash | −3,3 |
Retour en arrière
- Garder chaque version de la demande, datée, avec ses résultats sur les cas de test ; revenir à la précédente si la nouvelle fait moins bien.
- Changer une seule chose à la fois : sinon, on ne sait pas ce qui a aidé.
- À chaque nouveau modèle, repasser les cas : ce qui aidait peut gêner, comme les consignes de vérification sur Claude Opus 5 ; Mistral prévient qu'une simple mise à jour peut changer la réponse.
Variantes par outil
- Des balises XML pour séparer consignes, documents et exemples.
- Des exemples pertinents et variés, entre balises <example>.
- Un rôle dans le message système, pour le ton et le comportement.
- Les longs documents en haut, la question à la fin, les citations demandées d'abord.
- « Réfléchis soigneusement » plutôt qu'un plan écrit à la main.
- Plus de début de réponse imposé depuis les modèles Claude 4.6 ; sur Claude Opus 5, retirer les consignes de vérification héritées.
- Modèles qui raisonnent : des demandes simples et directes, pas de « réfléchis étape par étape », d'abord sans exemple.
- Un long contexte : les consignes au début et à la fin ; du XML plutôt que du JSON pour de nombreux documents.
- GPT-6 : une mission claire, le résultat voulu, pour qui, les contraintes et ce qui compte comme terminé.
- Chaque consigne une fois ; le ton décrit par des choix d'écriture concrets.
- Toujours des exemples, au même format ; trop d'exemples font copier.
- Des contraintes, un début de réponse à compléter, des demandes en chaîne ou en parallèle.
- Gemini 3 : précis et direct, sans langage trop persuasif, un seul style de séparateur ; le contexte d'abord, la question à la fin.
- « Réfléchis très soigneusement » seulement pour les raisonnements lourds, qui coûtent plus de tokens.
- Commencer par le rôle et la tâche ; structurer en Markdown ou en XML ; des exemples pour le format ; pas d'adjectifs vagues ; un arbre de décision pour les consignes qui se contredisent ; des notes sur une échelle en mots.
- DeepSeek, pour R1 : aucun exemple, le problème et le format dits directement.
D'après les guides des éditeurs, lus le 9 octobre 2026 ; ils sont en anglais, leurs conseils sont traduits. Les guides se contredisent sur les exemples et sur la place de la question : chacun vaut pour ses modèles.
Vérification
1ComprendrePourquoi écrire les critères avant la demande ?
Pour savoir ce qu'est une bonne réponse, pour tester chaque version de la demande sur vos cas, et pour en tirer la liste de contrôle de la relecture.
2ComprendreUn rôle d'expert rend-il les réponses plus justes ?
Non, d'après les mesures : il règle le ton et le point de vue. 162 rôles testés n'ont rien apporté à la justesse, et un rôle hors sujet peut faire refuser le modèle.
3AppliquerVotre assistant raisonne avant de répondre. Ajoutez-vous « réfléchis étape par étape » et cinq exemples ?
Non. D'abord sans : la consigne n'apporte que quelques points, parfois en fait perdre, et ralentit ; les exemples peuvent dégrader un modèle qui raisonne. Ajouter un exemple seulement si le format n'est pas tenu.
Lectures suivantes
Rien avant : c'est un point de départ.
Demandes avancées : exemples, rôles, critères et étapes
Les pages qui renvoient ici
Limites et sources
Beaucoup de mesures portent sur des modèles de 2020 à 2025 et sur des questions à choix multiples, pas sur des tâches d'entreprise.
Les gains cités par les éditeurs viennent de leurs propres tests ; OpenAI dit lui-même que les siens donnent une tendance.
La demande de classement, la liste de contrôle et l'entreprise sont fabriquées.
- Anthropic, bonnes pratiques ; Anthropic, critères de réussite ; OpenAI, modèles qui raisonnent ; OpenAI, GPT-6 ; Google, stratégies de demande ; Mistral, prompting ; DeepSeek-R1.
- Min et al., le rôle des exemples ; Zheng et al., les rôles ; Wharton, rapport 4 ; Wharton, rapport 2 ; Kojima et al. ; Madaan et al., Self-Refine ; Cook et al., les listes de contrôle.
- Le relevé :
apprendre/recherches/2026-10-09-demandes.json, partagé avec la page sur la formulation.
Écrit par Meridal, avec l'aide de l'IA ; chaque fait vérifié à sa source et relu avant publication. Texte et schémas sous licence CC BY 4.0 : reprenez-les en citant Meridal. Le code sous licence MIT.
Former vos équipes, et vous
Une demi-journée à deux journées, 550 € à 3 400 €