Sur cette page
Répondez de tête, puis ouvrez. Écrire une demande à une IA
1Quelles sont les cinq parties d'une bonne demande ?
Le contexte, la tâche, un exemple, le format, les critères. Seule la tâche est indispensable ; les autres rendent la réponse utilisable du premier coup.
2Vous joignez un rapport de trente pages et posez une question. Où placer la question ?
À la fin, après le document ; et demander de citer les passages sur lesquels la réponse s'appuie.
- Un modèle écrit sa réponse token après token, chacun choisi d'après tout le texte qui précède : changer un mot, l'ordre ou la mise en forme de la demande change ce texte, donc la réponse.
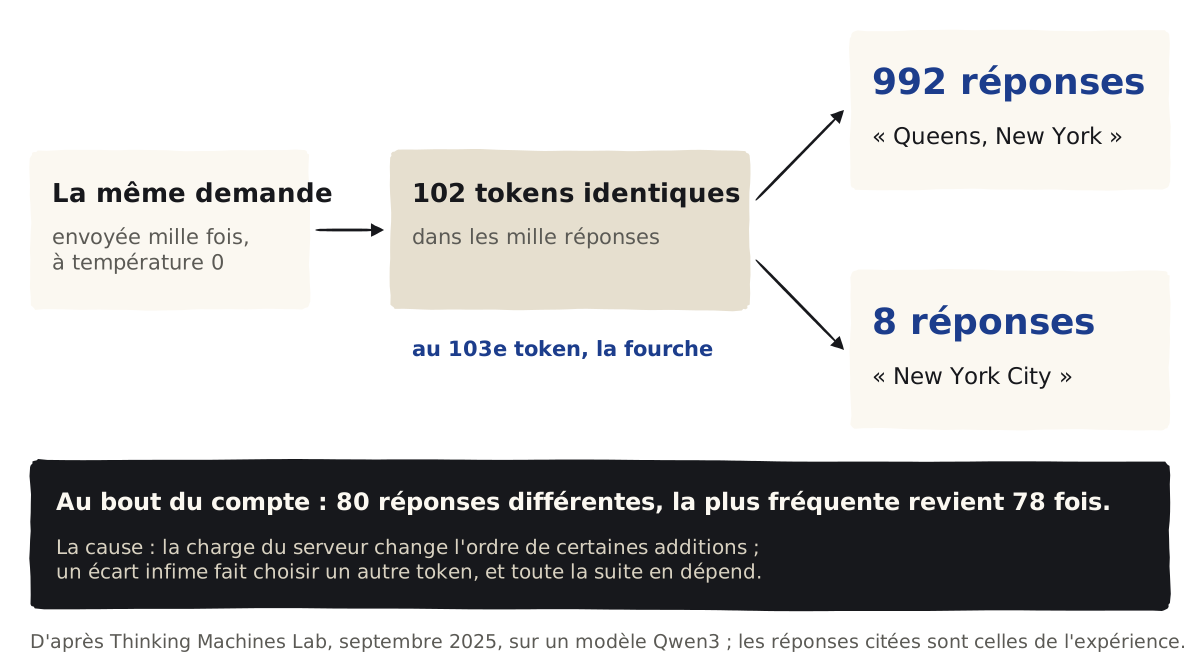
- Même sans rien changer, la réponse varie : mille envois identiques à température 0 ont donné 80 réponses différentes.
- La mise en forme seule a fait varier la justesse de jusqu'à 76 points sur un modèle de 2023 ; une partie de l'écart tient à la façon de noter, mais fixer le format de réponse reste le réglage le plus sûr.
- Dans une longue demande, le milieu compte moins que le début et la fin ; une demande ciblée d'environ 300 tokens a fait mieux que toute la conversation, 113 000 tokens, dans toutes les familles de modèles testées.
- Votre avis déplace la réponse : suggérer une mauvaise réponse a fait perdre jusqu'à 27 % de justesse, et « Vous êtes sûr ? » fait changer d'avis entre 32 et 86 % du temps.
Problème
Deux collègues posent presque la même question à l'assistant et obtiennent deux réponses différentes ; le lendemain, la même personne en obtient une troisième. L'outil est-il peu fiable, ou l'un des deux a-t-il mieux demandé ?
Les éditeurs le reconnaissent eux-mêmes. Google écrit que reformuler une demande de même sens change souvent la réponse. Mistral prévient qu'un autre modèle, ou une simple mise à jour, peut changer la réponse à une même demande. Sans savoir ce qui fait bouger la réponse, une équipe ne sait ni à quelle réponse se fier, ni comment écrire une demande qui tient.
Principe
Un modèle de langage écrit sa réponse un token après l'autre. À chaque pas, il calcule la probabilité de chaque suite possible d'après tout le texte qui précède : votre demande, les documents joints, et le début de sa propre réponse. Tout ce qui change ce texte change ces probabilités. Et dès qu'un token diffère, tout ce qui suit s'écrit à partir de lui : un petit écart au départ peut donner une réponse entièrement différente.
Le phénomène descend jusqu'au calcul. Sans rien changer à la demande, Thinking Machines a obtenu 80 réponses différentes sur mille envois : la charge du serveur modifie l'ordre de certaines additions, et un écart infime suffit à faire choisir un autre token.
Fonctionnement
La mise en forme. Des changements sans effet sur le sens, un séparateur, une majuscule, un espace, ont fait varier la justesse de LLaMA-2-13B de jusqu'à 76 points ; sur GPT-3.5, l'écart médian entre formats équivalents était de 6,4 points, et le meilleur format d'un modèle n'est pas celui d'un autre. Deux études tempèrent : une bonne part de l'écart vient de la notation rigide des tests, et la sensibilité tient surtout aux modèles qui ne respectent pas le format de réponse demandé. D'où le réglage le plus sûr : écrire le format attendu. Sans cette consigne, GPT-4o perdait 8,6 points.
L'ordre des exemples. Les quatre mêmes exemples, rangés autrement, ont fait passer des modèles de 2021 du niveau des meilleurs à celui du hasard ; le bon ordre pour un modèle ne l'est pas pour un autre. Un modèle penche vers les réponses placées près de la fin de la demande et vers celles qu'il a souvent lues.
La place. Dans une longue demande, un modèle exploite mieux le début et la fin que le milieu. Avec vingt documents joints, GPT-3.5-Turbo répondait juste dans 75,8 % des cas quand le bon document venait en premier, 53,8 % quand il était au milieu : moins bien que sans aucun document.
La bonne réponse selon la place du bon document
Voir en tableau
| Place du bon document | GPT-3.5-Turbo | Claude-1.3 |
|---|---|---|
| 1re sur 20 | 75,8 % | 59,9 % |
| 5e sur 20 | 57,2 % | 55,9 % |
| 10e sur 20 | 53,8 % | 56,8 % |
| 15e sur 20 | 55,4 % | 57,2 % |
| 20e sur 20 | 63,2 % | 60,1 % |
| Sans aucun document | 56,1 % | non publié ici |
| Le seul bon document | 88,3 % | non publié ici |
Les versions à long contexte ne faisaient pas mieux. En 2025, Chroma retrouve la dégradation sur 18 modèles : la même question, avec les mêmes faits, réussit mieux dans une demande ciblée d'environ 300 tokens que dans toute la conversation, 113 000 tokens, raisonnement activé compris ; un seul passage proche mais faux suffit à faire baisser le résultat.
Votre avis. Ajouter « je pense que la réponse est… » avec une mauvaise réponse a fait perdre jusqu'à 27 % de justesse ; après « Vous êtes sûr ? », les modèles changeaient leur réponse de 32 % du temps pour GPT-4 à 86 % pour Claude 1.3, plus souvent d'une réponse juste vers une fausse que l'inverse. La cause, selon les auteurs : dans les avis humains qui servent à dresser les modèles, les réponses qui vont dans le sens de l'utilisateur sont plus souvent préférées. En 2025, sur ChatGPT-4o, Claude Sonnet et Gemini 1.5 Pro, les modèles cédaient à une contradiction dans 58 % des cas.
La langue. Le français n'est pas toujours moins bien servi que l'anglais : sur le même test, GPT-4.1 y perd 4 points, DeepSeek-R1 en gagne près de 2. Anthropic mesure le français de Claude Sonnet 4.5 à 97,5 % de son anglais. Pour une question de culture, poser la question dans la langue du pays donne de meilleurs résultats que la traduire en anglais.
Le même test en anglais et en français
Voir en tableau
| Modèle | Anglais | Français |
|---|---|---|
| GPT-4.1 | 79,8 % | 75,7 % |
| DeepSeek-V3 | 79,6 % | 76,3 % |
| o4-mini | 73,7 % | 72,2 % |
| Qwen3-235B-Think | 80,7 % | 80,6 % |
| DeepSeek-R1 | 79,5 % | 81,3 % |
| GPT-4o | 59,9 % | 66,7 % |
Exemple détaillé
Une responsable des achats veut connaître la pénalité de retard prévue par le contrat d'un fournisseur. Exemple fabriqué. Sa première demande a quatre défauts : son avis en guise de question, la question avant les documents, six contrats au lieu d'un, et aucun format de réponse. Elle la réécrit.
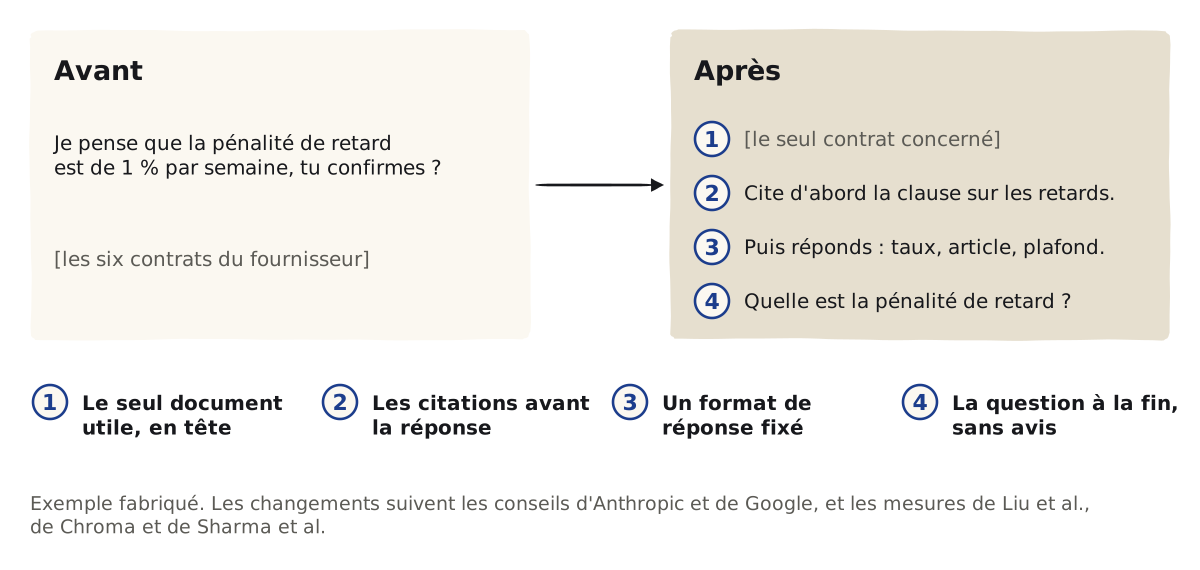
Chaque changement répond à une mesure ou à un conseil d'éditeur : le seul document utile parce qu'un passage proche mais faux fait baisser le résultat ; les citations d'abord et la question à la fin, comme le conseille Anthropic pour les longs documents ; un format fixé parce que son absence coûte des points ; et pas d'avis, parce qu'il entraîne la réponse.
La demande, après[Collez ici le contrat concerné, et lui seul.] Dans le contrat ci-dessus, cite d'abord, mot pour mot, la ou les clauses qui traitent des retards de livraison. Puis réponds dans ce format : Taux de pénalité : Article : Plafond : Si le contrat ne prévoit pas de pénalité de retard, écris « Non prévu ». Quelle est la pénalité de retard de livraison prévue par ce contrat ?
Le contrôle. Elle pose la demande deux fois, dans deux conversations neuves. Si les deux réponses concordent et que la clause citée dit bien ce taux, elle retient la réponse ; sinon, elle lit l'article cité. Deux réponses différentes sont un signal : la réponse n'est pas sûre.
Risques
Mise en place
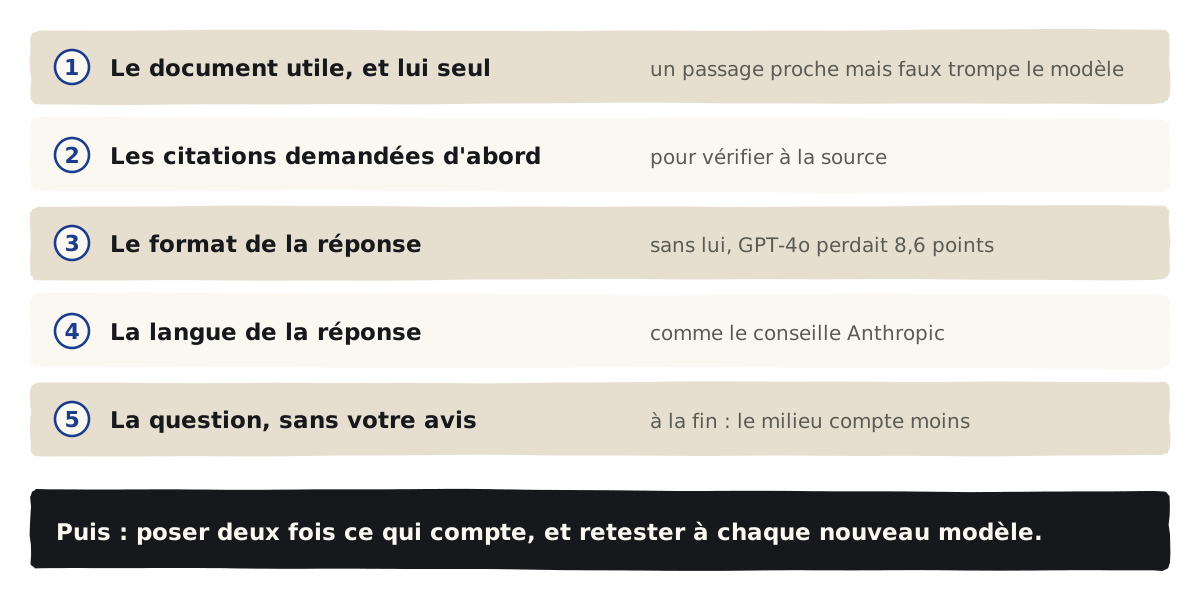
- Écrire le format de la réponse : les rubriques, l'ordre, la longueur.
- Mettre le document en tête et la question à la fin, comme le conseillent Anthropic et Google ; pour un très long document, répéter la consigne au début et à la fin, comme le conseille OpenAI.
- Ne joindre que l'utile : le bon contrat, la bonne période, pas tout le dossier.
- Demander les citations avant la réponse, pour pouvoir vérifier à la source.
- Taire votre avis, et vérifier par la source plutôt que par « Vous êtes sûr ? ».
- Poser deux fois ce qui compte, dans deux conversations : deux réponses différentes signalent une réponse incertaine.
- Écrire la langue de la réponse, comme le conseille Anthropic ; pour une question propre à la France, la poser en français.
- Garder ses demandes clés dans un fichier et les retester à chaque nouveau modèle.
Les techniques qui vont plus loin, exemples, rôles, critères et étapes : les demandes avancées.
Exercice
Pourquoi deux réponses, et comment obtenir la bonne ?
Un chargé de clientèle colle dans l'assistant trois ans de courriels avec un client, après avoir écrit en tête : « Je crois qu'il a déjà eu un geste commercial l'an dernier, tu peux me le confirmer ? » L'assistant confirme. Le lendemain, son collègue pose la question autrement et obtient « non ».
Ouvrir la correction
L'avis« Je crois que » pousse à confirmer : poser la question sans hypothèse.
Le volume et la placeTrois ans de courriels, la bonne information peut se perdre au milieu : ne joindre que la période utile, et mettre la question à la fin.
La preuveDemander de citer le courriel, avec sa date et son expéditeur.
Le désaccordDeux réponses opposées disent que la réponse n'est pas sûre : vérifier dans la messagerie avant de répondre au client.
Vérification
1ComprendrePourquoi la même demande peut-elle donner deux réponses différentes, même sans rien y changer ?
Parce que le modèle écrit token après token, chacun d'après tout ce qui précède : un écart infime dans le calcul, dû à la charge du serveur, peut faire choisir un autre token, et toute la suite en dépend. Mille envois identiques ont donné 80 réponses différentes.
2ComprendreOù placer la question dans une demande qui joint un long document, et pourquoi ?
À la fin, après le document, et la répéter au début s'il est très long : un modèle exploite mieux le début et la fin d'une demande que le milieu.
3AppliquerUne réponse de l'assistant vous paraît douteuse. Que faites-vous plutôt que de demander « Vous êtes sûr ? » ?
Demander la citation exacte du passage qui fonde la réponse, ou reposer la question dans une conversation neuve, sans donner votre avis. « Vous êtes sûr ? » fait abandonner des réponses justes.
Lectures suivantes
Rien avant : c'est un point de départ.
Effet de la formulation sur la réponse
Les pages qui renvoient ici
Limites et sources
La plupart des mesures portent sur des modèles de 2021 à 2025 ; aucune étude lue ne mesure la sensibilité à la mise en forme sur les modèles de 2026.
L'expérience des mille envois porte sur un modèle ouvert servi par ses auteurs ; on ne sait pas comment les grands éditeurs servent les leurs.
Les écarts entre l'anglais et le français viennent d'un test traduit ; une partie peut tenir à la traduction.
L'exemple et l'exercice sont fabriqués.
- Thinking Machines, le hasard du calcul ; Sclar et al., la mise en forme ; Hua et al., la notation ; Liu et al., Lost in the Middle ; Chroma, Context Rot ; Sharma et al., la complaisance ; MMLU-ProX ; Anthropic, bonnes pratiques ; Google, stratégies de demande ; OpenAI, guide de GPT-4.1.
- Le relevé :
apprendre/recherches/2026-10-09-demandes.json, partagé avec la page des demandes avancées.
Écrit par Meridal, avec l'aide de l'IA ; chaque fait vérifié à sa source et relu avant publication. Texte et schémas sous licence CC BY 4.0 : reprenez-les en citant Meridal. Le code sous licence MIT.
Former vos équipes, et vous
Une demi-journée à deux journées, 550 € à 3 400 €